# VideoMAE
## Ikhtisar
Model VideoMAE diusulkan dalam [VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training](https://huggingface.co/papers/2203.12602) oleh Zhan Tong, Yibing Song, Jue Wang, Limin Wang. VideoMAE memperluas masked auto encoders ([MAE](vit_mae)) ke video, dengan mengklaim kinerja state-of-the-art pada beberapa benchmark klasifikasi video.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Pre-training transformer video pada dataset berskala sangat besar umumnya diperlukan untuk mencapai kinerja unggulan pada dataset yang relatif kecil. Dalam makalah ini, kami menunjukkan bahwa video masked autoencoders (VideoMAE) adalah pembelajar yang efisien dalam penggunaan data untuk pre-training video self-supervised (SSVP). Kami terinspirasi oleh ImageMAE terbaru dan mengusulkan masking tabung video serta rekonstruksi yang dikustomisasi. Desain sederhana ini ternyata efektif untuk mengatasi kebocoran informasi yang disebabkan oleh korelasi temporal selama rekonstruksi video. Kami memperoleh tiga temuan penting mengenai SSVP: (1) Proporsi rasio masking yang sangat tinggi (yaitu, 90% hingga 95%) masih menghasilkan kinerja yang baik untuk VideoMAE. Konten video yang redundan secara temporal memungkinkan rasio masking yang lebih tinggi dibandingkan pada gambar. (2) VideoMAE mencapai hasil yang mengesankan pada dataset yang sangat kecil (yaitu, sekitar 3k-4k video) tanpa menggunakan data tambahan apa pun. Hal ini sebagian disebabkan oleh tugas rekonstruksi video yang menantang, yang memaksa pembelajaran struktur tingkat tinggi. (3) VideoMAE menunjukkan bahwa kualitas data lebih penting daripada kuantitas data untuk SSVP. Pergeseran domain antara dataset pre-training dan dataset target merupakan isu penting dalam SSVP. Yang patut dicatat, VideoMAE kami dengan backbone ViT vanilla dapat mencapai 83,9% pada Kinects-400, 75,3% pada Something-Something V2, 90,8% pada UCF101, dan 61,1% pada HMDB51 tanpa menggunakan data tambahan apa pun.*
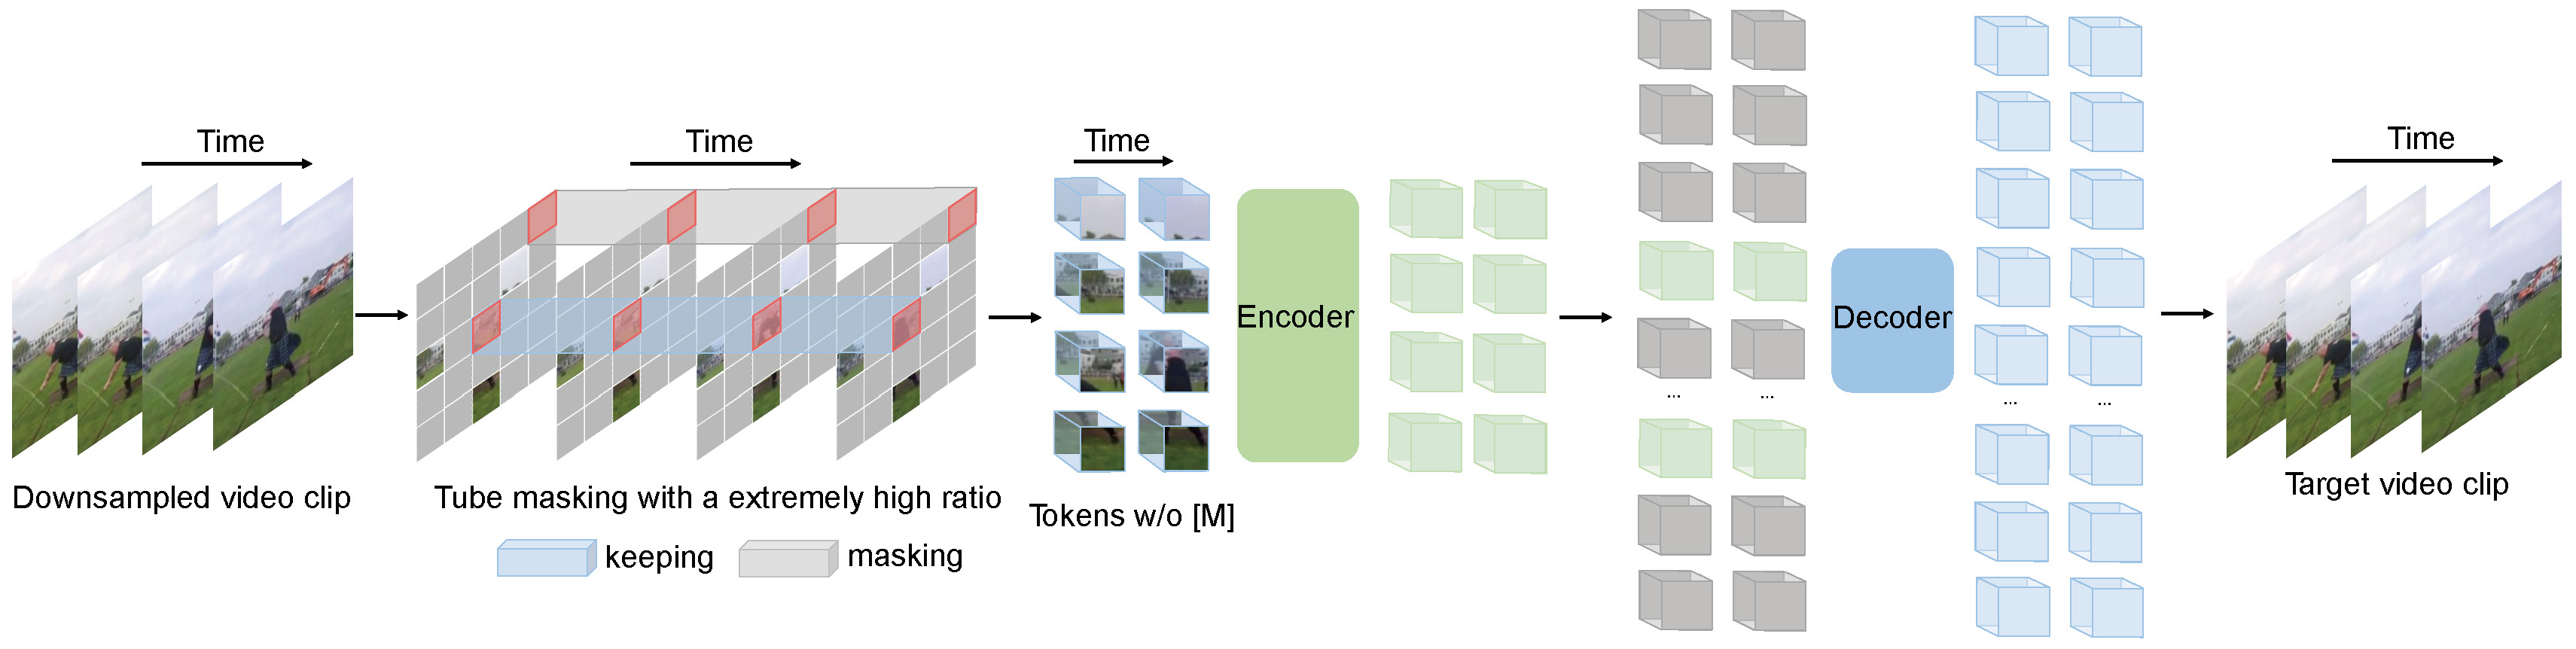 Pre-training VideoMAE. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/MCG-NJU/VideoMAE).
## Menggunakan Scaled Dot Product Attention (SDPA)
PyTorch menyertakan operator scaled dot-product attention (SDPA) native sebagai bagian dari `torch.nn.functional`. Fungsi ini mencakup beberapa implementasi yang dapat diterapkan tergantung pada input dan perangkat keras yang digunakan. Lihat [dokumentasi resmi](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) atau halaman [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) untuk informasi lebih lanjut.
SDPA digunakan secara default untuk `torch>=2.1.1` ketika implementasi tersedia, tetapi Anda juga dapat mengatur `attn_implementation="sdpa"` di `from_pretrained()` untuk secara eksplisit meminta penggunaan SDPA.
```python
from transformers import VideoMAEForVideoClassification
model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics", attn_implementation="sdpa", device_map="auto")
...
```
Untuk percepatan terbaik, kami merekomendasikan memuat model dalam presisi setengah (misalnya `torch.float16` atau `torch.bfloat16`).
Pada benchmark lokal (A100-40GB, PyTorch 2.3.0, OS Ubuntu 22.04) dengan `float32` dan model `MCG-NJU/videomae-base-finetuned-kinetics`, kami melihat peningkatan kecepatan berikut selama inferensi.
| Ukuran batch | Rata-rata waktu inferensi (ms), mode eager | Rata-rata waktu inferensi (ms), model sdpa | Percepatan, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 37 | 10 | 3.7 |
| 2 | 24 | 18 | 1.33 |
| 4 | 43 | 32 | 1.34 |
| 8 | 84 | 60 | 1.4 |
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan VideoMAE. Jika Anda tertarik untuk mengirimkan sumber agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber yang sudah ada.
**Klasifikasi video**
- [notebook](https://github.com/huggingface/notebooks/blob/main/examples/video_classification.ipynb) yang menunjukkan cara
untuk melakukan fine-tuning model VideoMAE pada dataset kustom.
- [Panduan tugas klasifikasi video](../tasks/video_classification)
- [Space 🤗](https://huggingface.co/spaces/sayakpaul/video-classification-ucf101-subset) yang menunjukkan cara melakukan inferensi dengan model klasifikasi video.
## VideoMAEConfig[[transformers.VideoMAEConfig]]
#### transformers.VideoMAEConfig[[transformers.VideoMAEConfig]]
```python
transformers.VideoMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, num_frames: int = 16, tubelet_size: int = 2, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, qv_bias: bool = True, use_mean_pooling: bool = True, decoder_num_attention_heads: int = 6, decoder_hidden_size: int = 384, decoder_num_hidden_layers: int = 4, decoder_intermediate_size: int = 1536, norm_pix_loss: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/configuration_videomae.py#L24)
**Parameter:**
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `16`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
num_frames (`int`, *opsional*, default 16) : Jumlah frame dalam setiap video.
tubelet_size (`int`, *opsional*, defaultnya 2) : Jumlah tubelet.
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
qv_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan bias ke query dan value pada lapisan self-attention.
use_mean_pooling (`bool`, *opsional*, defaultnya `True`) : Apakah akan melakukan mean pooling pada hidden states akhir alih-alih menggunakan hidden state akhir dari token [CLS].
decoder_num_attention_heads (`int`, *opsional*, defaultnya 6) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder.
decoder_hidden_size (`int`, *opsional*, defaultnya 384) : Dimensi dari decoder.
decoder_num_hidden_layers (`int`, *opsional*, defaultnya 4) : Jumlah lapisan tersembunyi dalam decoder.
decoder_intermediate_size (`int`, *opsional*, default 1536) : Dimensi dari lapisan "intermediate" (yaitu, feed-forward) dalam decoder.
norm_pix_loss (`bool`, *opsional*, defaultnya `True`) : Apakah akan menormalisasi piksel patch target.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari VideoMAEModel. Kelas ini digunakan untuk membuat instans model Videomae sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [MCG-NJU/videomae-base](https://huggingface.co/MCG-NJU/videomae-base)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import VideoMAEConfig, VideoMAEModel
>>> # Initializing a VideoMAE videomae-base style configuration
>>> configuration = VideoMAEConfig()
>>> # Randomly initializing a model from the configuration
>>> model = VideoMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## VideoMAEImageProcessor[[transformers.VideoMAEImageProcessor]]
#### transformers.VideoMAEImageProcessor[[transformers.VideoMAEImageProcessor]]
```python
transformers.VideoMAEImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/image_processing_videomae.py#L35)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Membangun pemroses gambar VideoMAEImageProcessor.
#### preprocess[[transformers.VideoMAEImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/image_processing_videomae.py#L53)
**Parameter:**
videos (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Video atau batch video untuk dipreprocess. Mengharapkan satu video (daftar frame) atau batch video (daftar dari daftar frame). Setiap frame dapat berupa gambar PIL, array numpy, atau tensor torch dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan frame dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## VideoMAEImageProcessorPil[[transformers.VideoMAEImageProcessorPil]]
#### transformers.VideoMAEImageProcessorPil[[transformers.VideoMAEImageProcessorPil]]
```python
transformers.VideoMAEImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/image_processing_pil_videomae.py#L33)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Membangun pemroses gambar VideoMAEImageProcessor.
#### preprocess[[transformers.VideoMAEImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/image_processing_pil_videomae.py#L51)
**Parameter:**
videos (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Video atau batch video untuk dipreprocess. Mengharapkan satu video (daftar frame) atau batch video (daftar dari daftar frame). Setiap frame dapat berupa gambar PIL, array numpy, atau tensor torch dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan frame dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## VideoMAEVideoProcessor[[transformers.VideoMAEVideoProcessor]]
#### transformers.VideoMAEVideoProcessor[[transformers.VideoMAEVideoProcessor]]
```python
transformers.VideoMAEVideoProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/video_processing_videomae.py#L25)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
do_sample_frames (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan mengambil sampel frame dari video sebelum diproses atau memproses seluruh video.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Metadata dari video yang berisi informasi tentang durasi total, fps, dan jumlah total frame. Metadata ini akan digunakan untuk mengambil sampel frame dari video atau menghitung timestamp. Jangan mengirim metadata apa pun kecuali Anda mencoba mendekode video secara manual sebelum diproses
fps (`Annotated[int | float | None, None]`, *kwargs*) : Bingkai target yang akan disampel per detik saat `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Jumlah maksimum frame yang akan disampelkan saat `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan mengembalikan metadata video atau tidak. Metadata video adalah objek yang berisi informasi tentang durasi video, fps, backend decoding, dll.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek PyTorch `torch.Tensor`. - `'np'`: Mengembalikan objek NumPy `np.ndarray`.
- ****kwargs** ([VideosKwargs](/docs/transformers/main/id/main_classes/processors#transformers.VideosKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
Membangun prosesor video VideoMAEVideoProcessor.
#### preprocess[[transformers.VideoMAEVideoProcessor.preprocess]]
```python
preprocess(videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/video_processing_videomae.py#L41)
**Parameter:**
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`) : Video yang akan dipreprocess. Mengharapkan satu video atau batch video dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan video dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
do_sample_frames (`bool`, *kwargs*, *opsional*) : Apakah akan mengambil sampel frame dari video sebelum diproses atau memproses seluruh video.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Metadata dari video yang berisi informasi tentang durasi total, fps, dan jumlah total frame. Metadata ini akan digunakan untuk mengambil sampel frame dari video atau menghitung timestamp. Jangan mengirim metadata apa pun kecuali Anda mencoba mendekode video secara manual sebelum diproses
fps (`Annotated[int | float | None, None]`, *kwargs*) : Bingkai target yang akan disampel per detik saat `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Jumlah maksimum frame yang akan disampelkan saat `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *opsional*) : Apakah akan mengembalikan metadata video atau tidak. Metadata video adalah objek yang berisi informasi tentang durasi video, fps, backend decoding, dll.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## VideoMAEModel[[transformers.VideoMAEModel]]
#### transformers.VideoMAEModel[[transformers.VideoMAEModel]]
```python
transformers.VideoMAEModel(config: VideoMAEConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L398)
**Parameter:**
config ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Videomae polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.VideoMAEModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L417)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor). Lihat [VideoMAEImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor) untuk memproses gambar).
bool_masked_pos (`torch.BoolTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Posisi yang dimask secara boolean. Menunjukkan patch mana yang dimask (1) dan mana yang tidak (0). Setiap video dalam batch harus memiliki jumlah patch yang dimask sama. Jika `None`, maka semua patch dianggap. Panjang sekuens adalah `(num_frames // tubelet_size) * (image_size // patch_size) ** 2`.
**Mengembalikan:** [BaseModelOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutput) atau `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) dan input.
Metode forward dari [VideoMAEModel](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEModel
>>> from huggingface_hub import hf_hub_download
>>> # replace this with your own video file
>>> video_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEModel.from_pretrained("MCG-NJU/videomae-base")
>>> # prepare video for the model
>>> inputs = video_processor(video_path, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1568, 768]
```
## VideoMAEForPreTraining[[transformers.VideoMAEForPreTraining]]
`VideoMAEForPreTraining` menyertakan decoder di bagian atas untuk pre-training self-supervised.
#### transformers.VideoMAEForPreTraining[[transformers.VideoMAEForPreTraining]]
```python
transformers.VideoMAEForPreTraining(config: VideoMAEConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L511)
**Parameter:**
config ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer VideoMAE dengan decoder di bagian atas untuk pra-pelatihan tanpa pengawasan.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.VideoMAEForPreTraining.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: BoolTensor, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L529)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor). Lihat [VideoMAEImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor) untuk memproses gambar).
bool_masked_pos (`torch.BoolTensor` dengan bentuk `(batch_size, sequence_length)`) : Posisi yang dimask secara Boolean. Menunjukkan patch mana yang dimask (1) dan mana yang tidak (0). Setiap video dalam batch harus memiliki jumlah patch yang dimask sama. Panjang sekuens adalah `(num_frames // tubelet_size) * (image_size // patch_size) ** 2`.
**Mengembalikan:** `VideoMAEForPreTrainingOutput` atau `tuple(torch.Tensor)`
Sebuah `VideoMAEForPreTrainingOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) dan input.
Metode forward dari [VideoMAEForPreTraining](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEForPreTraining) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`) -- Loss rekonstruksi piksel.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, patch_size ** 2 * num_channels)`) -- Logits rekonstruksi piksel.
- **hidden_states** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, VideoMAEForPreTraining
>>> import numpy as np
>>> import torch
>>> num_frames = 16
>>> video = list(np.random.randint(0, 256, (num_frames, 3, 224, 224)))
>>> image_processor = AutoImageProcessor.from_pretrained("MCG-NJU/videomae-base")
>>> model = VideoMAEForPreTraining.from_pretrained("MCG-NJU/videomae-base")
>>> pixel_values = image_processor(video, return_tensors="pt").pixel_values
>>> num_patches_per_frame = (model.config.image_size // model.config.patch_size) ** 2
>>> seq_length = (num_frames // model.config.tubelet_size) * num_patches_per_frame
>>> bool_masked_pos = torch.randint(0, 2, (1, seq_length)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss = outputs.loss
```
## VideoMAEForVideoClassification[[transformers.VideoMAEForVideoClassification]]
#### transformers.VideoMAEForVideoClassification[[transformers.VideoMAEForVideoClassification]]
```python
transformers.VideoMAEForVideoClassification(config: VideoMAEConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L684)
**Parameter:**
config ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer VideoMAE dengan kepala klasifikasi video di atasnya (lapisan linear di atas keadaan tersembunyi yang dirata-rata dari semua token) misalnya untuk ImageNet.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.VideoMAEForVideoClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/videomae/modeling_videomae.py#L698)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor). Lihat [VideoMAEImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [VideoMAEImageProcessor](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEImageProcessor) untuk memproses gambar).
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label untuk menghitung loss klasifikasi/regresi gambar. Indeks harus berada dalam `[0, ..., config.num_labels - 1]`. Jika `config.num_labels == 1`, loss regresi dihitung (Mean-Square loss). Jika `config.num_labels > 1`, loss klasifikasi dihitung (Cross-Entropy).
**Mengembalikan:** [ImageClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) atau `tuple(torch.Tensor)`
[ImageClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([VideoMAEConfig](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEConfig)) dan input.
Metode forward dari [VideoMAEForVideoClassification](/docs/transformers/main/id/model_doc/videomae#transformers.VideoMAEForVideoClassification) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels)`) -- Skor klasifikasi (atau regresi jika config.num_labels==1) (sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap tahap) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states (juga disebut feature maps) dari model pada output dari setiap tahap.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, patch_size, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import VideoMAEVideoProcessor, VideoMAEForVideoClassification
>>> from huggingface_hub import hf_hub_download
>>> # replace this with your own video file
>>> video_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> video_processor = VideoMAEVideoProcessor.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")
>>> model = VideoMAEForVideoClassification.from_pretrained("MCG-NJU/videomae-base-finetuned-kinetics")
>>> inputs = video_processor(video_path, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
... logits = outputs.logits
>>> # model predicts one of the 400 Kinetics-400 classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
eating spaghetti
```