# Ses Spektrogram Dönüşümü
## Genel Bakış
Audio Spectrogram Transformer modeli, Yuan Gong, Yu-An Chung ve James Glass tarafından [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778) makalesinde önerilmiştir. Audio Spectrogram Transformer, ses verisini bir görüntüye (spektrograma) dönüştürerek [Vision Transformer](vit)'ı ses üzerine uygular. Model, ses sınıflandırma için en iyi sonuçları elde eder.
Makalenin özeti aşağıdaki gibidir:
*Geçen on yıl boyunca, konvolüsyonel sinir ağları (CNN'ler), ses spektrogramlarından ilgili etiketlere doğrudan bir eşleme öğrenmeyi amaçlayan uçtan uca ses sınıflandırma modellerinin ana yapı taşı olarak yaygın şekilde benimsenmiştir. Uzun menzilli küresel bağlamı daha iyi yakalamak için son zamanlardaki bir eğilim, CNN'nin üzerine bir öz-dikkat mekanizması ekleyerek CNN-dikkat hibrit modeli oluşturmaktır. Ancak, CNN'ye bağımlılığın gerekli olup olmadığı ve saf olarak dikkate dayalı sinir ağlarının ses sınıflandırmada iyi performans elde etmek için yeterli olup olmadığı belirsizdir. Bu makalede, soruyu Audio Spectrogram Transformer (AST) ile yanıtlandırıyoruz; AST, ses sınıflandırma için ilk konvolüsyonsuz, saf olarak dikkate dayalı modeldir. AST'yi çeşitli ses sınıflandırma kıstaslarında değerlendiriyoruz; model, AudioSet'te 0,485 mAP, ESC-50'de %95,6 ve Speech Commands V2'de %98,1 doğruluk oranlarıyla yeni en iyi sonuçları elde etmektedir.*
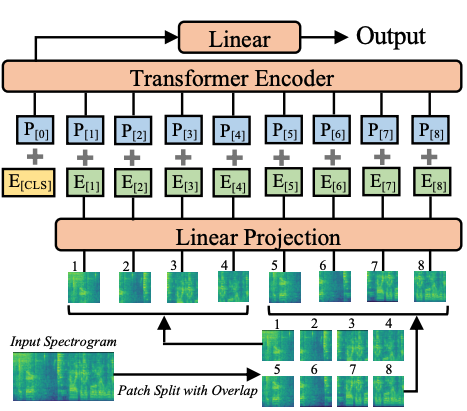 Audio Spectrogram Transformer mimarisi. Orijinal makaleden alınmıştır.
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/YuanGongND/ast) bulunabilir.
## Kullanım ipuçları
- Kendi veri setinizde Audio Spectrogram Transformer (AST) modelini ince ayar yaparken, girdi normalizasyonunu (
girdinin ortalamanın 0 ve standart sapmanın 0.5 olduğundan emin olun). [ASTFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor) bununla ilgilenir. Varsayılan olarak AudioSet ortalama ve standart sapma değerlerini kullandığına dikkat edin. Yazarların bir aşağı akış (downstream) veri seti için istatistikleri nasıl hesapladığını görmek için [`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py) dosyasını inceleyebilirsiniz.
- AST'nin düşük bir öğrenme hızına ihtiyaç duyduğunu unutmayın (yazarlar,
[PSLA makalesi](https://huggingface.co/papers/2102.01243)) ve hızlı bir şekilde yakınsar, bu nedenle göreviniz için uygun bir öğrenme hızı ve öğrenme hızı zamanlayıcısı aramanızı öneririz.
### Ölçekli Nokta Çarpımı Dikkat (SDPA) Kullanımı
PyTorch, `torch.nn.functional` parçası olarak yerel ölçekli nokta çarpımı dikkati (SDPA) operatörünü içerir. Bu fonksiyon, girdilere ve kullanılan donanıma bağlı olarak uygulanabilecek çeşitli uygulamaları kapsar. Daha fazla bilgi için [resmi dokümantasyonu](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) veya [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) sayfasına bakın.
`torch>=2.1.1` için bir uygulama mevcut olduğunda varsayılan olarak SDPA kullanılır, ancak SDPA'nın kullanılmasını açıkça istemek için `from_pretrained()` içinde `attn_implementation="sdpa"` ayarlayabilirsiniz.
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
En iyi hızlanmalar için, modelin yarım hassasiyette (ör. `torch.float16` veya `torch.bfloat16`) yüklenmesini öneririz.
Yerel bir benchmark'ta (A100-40GB, PyTorch 2.3.0, OS Ubuntu 22.04) `float32` ve `MIT/ast-finetuned-audioset-10-10-0.4593` modeliyle, çıkarım sırasında aşağıdaki hızlanmaları gözlemledik.
| Toplu işlem boyutu | Ortalama çıkarım süresi (ms), aceleci mod | Ortalama çıkarım süresi (ms), sdpa modeli | Hızlandırma, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## Kaynaklar
Audio Spectrogram Transformer ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- Ses sınıflandırma için AST ile çıkarımın gösterildiği bir defter [burada](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST) bulunabilir.
- Bu [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb) [ASTForAudioClassification](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) sınıfını destekler.
- Bkz: [Ses sınıflandırma](../tasks/audio_classification).
Buraya bir kaynak eklemek isterseniz, lütfen bir Pull Request açmaktan çekinmeyin; inceleyeceğiz! Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şeyi göstermesi beklenir.
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
qkv_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Sorgulara, anahtarlara ve değerlere bir sapma (bias) eklenip eklenmeyeceğini belirtir.
frequency_stride (`int`, *isteğe bağlı*, varsayılan 10) : Spektrogramları yama (patch) haline getirirken kullanılacak frekans adımı.
time_stride (`int`, *isteğe bağlı*, varsayılan 10) : Spektrogramları yama (patch) haline getirirken kullanılacak zamansal atlama (stride).
max_length (`int`, *isteğe bağlı*, varsayılan 1024) : Spektrogramların zamansal boyutu.
num_mel_bins (`int`, *isteğe bağlı*, varsayılan `128`) : Her giriş çerçevesi için kullanılan mel özellik sayısı. `AutoFeatureExtractor` sınıfında kullanılan değerle eşleşmelidir.
Bu, bir Audio Spectrogram TransformerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Audio Spectrogram Transformer modeli örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneklendiğinde, [MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593) ile benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**Parametreler:**
feature_size (`int`, *isteğe bağlı*, varsayılan 1) : Çıkarılan özelliklerin boyutu.
sampling_rate (`int`, *opsiyonel*, varsayılan 16000) : Ses dosyalarının dijitalleştirileceği örneklem hızı, hertz (Hz) cinsinden ifade edilir.
num_mel_bins (`int`, *isteğe bağlı*, varsayılan 128) : Mel frekans kutucuğu sayısı.
max_length (`int`, *isteğe bağlı*, varsayılan 1024) : Çıkarılan özelliklerin doldurulacağı/kısaltılacağı maksimum uzunluk.
do_normalize (`bool`, *isteğe bağlı*, varsayılan `True`) : `mean` ve `std` kullanılarak log-Mel özelliklerinin normalize edilip edilmeyeceği.
mean (`float`, *opsiyonel*, varsayılan -4.2677393) : log-Mel özelliklerini normalize etmek için kullanılan ortalama değer. Varsayılan olarak AudioSet ortalamasını kullanır.
std (`float`, *opsiyonel*, varsayılan 4.5689974) : log-Mel özelliklerini normalize etmek için kullanılan standart sapma değeri. Varsayılan olarak AudioSet standart sapmasını kullanır.
return_attention_mask (`bool`, *isteğe bağlı*, varsayılan `False`) : [__call__()](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) `attention_mask` döndürmeli mi?
Bir Audio Spectrogram Transformer (AST) özellik çıkarıcısı oluşturur.
Bu özellik çıkarıcı, ana yöntemlerin çoğunu içeren [SequenceFeatureExtractor](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.SequenceFeatureExtractor) sınıfından devralır. Kullanıcıların bu yöntemler hakkında daha fazla bilgi için bu üst sınıfa başvurması gerekir.
Bu sınıf, yüklü olması durumunda TorchAudio'yu, değilse numpy'yi kullanarak ham ses verisinden mel-filtre bankası özelliklerini çıkarır, bunları sabit bir uzunluğa göre doldurur/kısaltır ve ortalama ile standart sapma kullanarak normalize eder.
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**Parametreler:**
raw_speech (`np.ndarray`, `list[float]`, `list[np.ndarray]`, `list[list[float]]`) : Dolgusu yapılacak dizi veya dizi partisi. Her dizi, bir numpy dizisi, bir float değerleri listesi, bir numpy dizileri listesi veya float değerleri listeleri listesi olabilir. Tek kanallı ses olmalıdır, stereo değil; yani her zaman adımı için tek bir float.
sampling_rate (`int`, *isteğe bağlı*) : `raw_speech` girdisinin örneklenmiş olduğu örneklem hızı. Sessiz hataları önlemek için `sampling_rate` değerini forward çağrısında geçmek şiddetle önerilir.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, Python tamsayı listesi yerine tensörler döndürülür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: Numpy `np.ndarray` nesnelerini döndürür.
Bir veya birden fazla diziyi model için özelliklendirmek ve hazırlamak için ana yöntem.
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**Parametreler:**
config ([ASTConfig](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumlar (hidden-states) üreten çıplak Audio Spectrogram Transformer Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**Parametreler:**
input_values (`torch.Tensor`, şekli `(batch_size, max_length, num_mel_bins)`) : Ham ses dalgasından çıkarılan mel özelliklerinin float değerleri. Ham ses dalgası, bir `.flac` veya `.wav` ses dosyasını `list[float]` tipinde bir diziye, `numpy.ndarray` veya `torch.Tensor` içine yükleyerek elde edilebilir; *örneğin* torchcodec kütüphanesi (`pip install torchcodec`) veya soundfile kütüphanesi (`pip install soundfile`) aracılığıyla. Diziyi `input_features` haline getirmek için, mel özelliklerini çıkarmak, dolgu yapmak ve `torch.Tensor` tipinde bir tensöre dönüştürmek üzere [AutoFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoFeatureExtractor) kullanılmalıdır. [__call__()](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) bölümüne bakın
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([ASTConfig](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[ASTModel](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**Parametreler:**
config ([ASTConfig](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde bir ses sınıflandırma başlığı (toplanmış çıktının üzerinde doğrusal bir katman) bulunan Audio Spectrogram Transformer modeli, örneğin AudioSet, Speech Commands v2 gibi veri setleri için.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**Parametreler:**
input_values (`torch.Tensor`, şekli `(batch_size, max_length, num_mel_bins)`) : Ham ses dalgasından çıkarılan mel özelliklerinin float değerleri. Ham ses dalgası, bir `.flac` veya `.wav` ses dosyasını `list[float]` tipinde bir diziye, `numpy.ndarray` veya `torch.Tensor` içine yükleyerek elde edilebilir; *örneğin* torchcodec kütüphanesi (`pip install torchcodec`) veya soundfile kütüphanesi (`pip install soundfile`) aracılığıyla. Diziyi `input_features` haline getirmek için, mel özelliklerini çıkarmak, dolgu yapmak ve `torch.Tensor` tipinde bir tensöre dönüştürmek üzere [AutoFeatureExtractor](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoFeatureExtractor) kullanılmalıdır. [__call__()](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) bölümüne bakın
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Ses sınıflandırma/geri dönüş kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels == 1` ise bir geri dönüş kaybı (Ortalama Kare kaybı) hesaplanır, `config.num_labels > 1` ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([ASTConfig](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[ASTForAudioClassification](/docs/transformers/v5.23.0/tr/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```