# InstructBLIP
## Resumen
El modelo InstructBLIP fue propuesto en [InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning](https://huggingface.co/papers/2305.06500) por Wenliang Dai, Junnan Li, Dongxu Li, Anthony Meng Huat Tiong, Junqi Zhao, Weisheng Wang, Boyang Li, Pascale Fung y Steven Hoi. InstructBLIP aprovecha la arquitectura [BLIP-2](blip-2) para el ajuste de instrucciones visuales.
El resumen del artículo es el siguiente:
*Los modelos de lenguaje de propósito general que pueden resolver diversas tareas del dominio del lenguaje han surgido impulsados por el pipeline de preentrenamiento y ajuste por instrucciones. Sin embargo, construir modelos de visión-lenguaje de propósito general es un desafío debido a la mayor discrepancia de tareas introducida por la entrada visual adicional. Aunque el preentrenamiento de visión-lenguaje ha sido ampliamente estudiado, el ajuste por instrucciones de visión-lenguaje sigue siendo relativamente menos explorado. En este artículo, realizamos un estudio sistemático y exhaustivo sobre el ajuste por instrucciones de visión-lenguaje basado en los modelos BLIP-2 preentrenados. Recopilamos una amplia variedad de 26 conjuntos de datos públicos disponibles, los transformamos al formato de ajuste por instrucciones y los clasificamos en dos clusters para el ajuste por instrucciones con datos incluidos y la evaluación zero-shot con datos excluidos. Además, introducimos la extracción de características visuales consciente de las instrucciones, un método crucial que permite al modelo extraer características informativas adaptadas a la instrucción dada. Los modelos InstructBLIP resultantes alcanzan un rendimiento zero-shot del estado del arte en los 13 conjuntos de datos excluidos, superando sustancialmente a BLIP-2 y al más grande Flamingo. Nuestros modelos también conducen a un rendimiento del estado del arte cuando se ajustan finamente en tareas descendentes individuales (p. ej., 90,7 % de precisión en ScienceQA IMG). Además, demostramos cualitativamente las ventajas de InstructBLIP sobre los modelos multimodales concurrentes.*
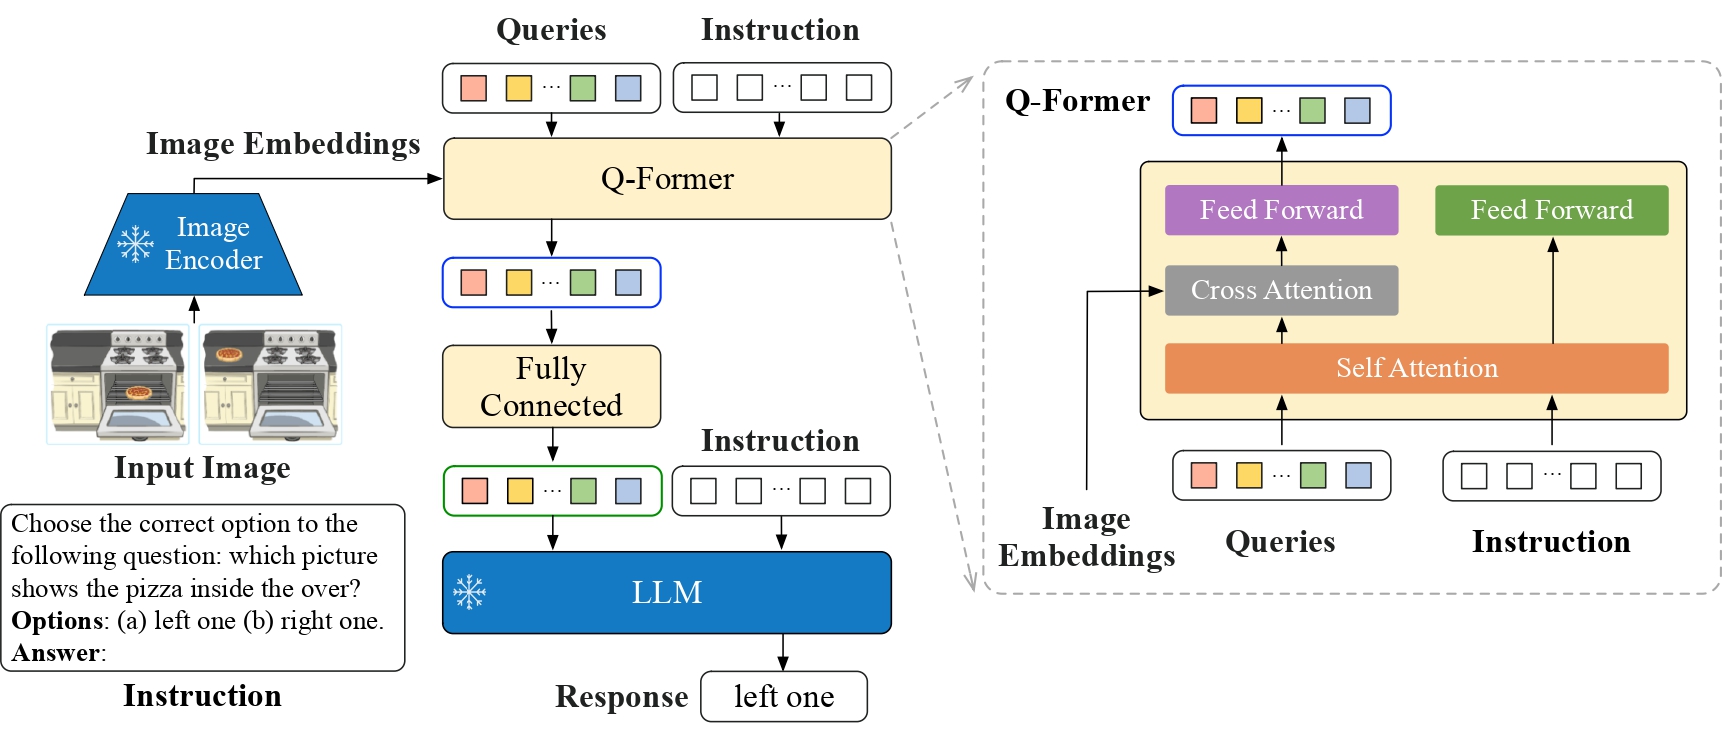 Arquitectura de InstructBLIP. Tomada del artículo original.
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/salesforce/LAVIS/tree/main/projects/instructblip).
## Consejos de uso
InstructBLIP utiliza la misma arquitectura que [BLIP-2](blip-2) con una pequeña pero importante diferencia: también alimenta el prompt de texto (instrucción) al Q-Former.
> [!NOTE]
> Los modelos BLIP posteriores a la versión v4.46 emitirán advertencias sobre la adición de `processor.num_query_tokens = {{num_query_tokens}}` y la expansión de la capa de embeddings del modelo para añadir el token especial ``. Se recomienda encarecidamente añadir los atributos al procesador si usted es el propietario del checkpoint del modelo, o abrir un PR si no lo es. Añadir estos atributos significa que BLIP añadirá el número de tokens de consulta requeridos por imagen y expandirá el texto con tantos marcadores de posición `` como tokens de consulta haya. Normalmente son unos 500 tokens por imagen, así que asegúrese de que el texto no se trunca, ya que de lo contrario habrá un fallo al fusionar los embeddings.
Los atributos se pueden obtener desde la configuración del modelo, como `model.config.num_query_tokens`, y la expansión de los embeddings del modelo se puede realizar siguiendo [este enlace](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## InstructBlipConfig[[transformers.InstructBlipConfig]]
#### transformers.InstructBlipConfig[[transformers.InstructBlipConfig]]
```python
transformers.InstructBlipConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L106)
**Parámetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de visión.
qformer_config (`dict`, *opcional*) : Diccionario de opciones de configuración utilizadas para inicializar [InstructBlipQFormerConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipQFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de texto.
num_query_tokens (`int`, *opcional*, valor predeterminado: 32) : El número de tokens de consulta que se pasan a través del Transformer.
image_token_index (`int`, *opcional*) : El índice del token de imagen utilizado como marcador de posición para las imágenes de entrada.
initializer_factor (`float`, *opcional*, valor predeterminado `1.0`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
Esta es la clase de configuración para almacenar la configuración de un InstructBlipModel. Se utiliza para instanciar un modelo Instructblip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import (
... InstructBlipVisionConfig,
... InstructBlipQFormerConfig,
... OPTConfig,
... InstructBlipConfig,
... InstructBlipForConditionalGeneration,
... )
>>> # Initializing a InstructBlipConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipConfig()
>>> # Initializing a InstructBlipForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a InstructBlipConfig from a InstructBlipVisionConfig, InstructBlipQFormerConfig and any PreTrainedConfig
>>> # Initializing InstructBLIP vision, InstructBLIP Q-Former and language model configurations
>>> vision_config = InstructBlipVisionConfig()
>>> qformer_config = InstructBlipQFormerConfig()
>>> text_config = OPTConfig()
>>> config = InstructBlipConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
#### transformers.InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
```python
transformers.InstructBlipVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L29)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `1408`) : Dimensión de las representaciones ocultas.
intermediate_size (`int`, *opcional*, valor predeterminado `6144`) : Dimensión de las representaciones MLP.
num_hidden_layers (`int`, *opcional*, valor predeterminado `39`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `16`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `14`) : El tamaño (resolución) de cada parche.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-06`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `1e-10`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
qkv_bias (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe añadir un sesgo a las consultas, claves y valores.
Esta es la clase de configuración para almacenar la configuración de un InstructBlipModel. Se utiliza para instanciar un modelo Instructblip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import InstructBlipVisionConfig, InstructBlipVisionModel
>>> # Initializing a InstructBlipVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVisionConfig()
>>> # Initializing a InstructBlipVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
#### transformers.InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
```python
transformers.InstructBlipQFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L64)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `30522`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La probabilidad de dropout para todas las capas totalmente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para las probabilidades de atención.
max_position_embeddings (`int`, *opcional*, valor predeterminado `512`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-12`) : El epsilon utilizado por las capas de normalización de capas.
pad_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el relleno en el vocabulario.
cross_attention_frequency (`int`, *opcional*, valor predeterminado 2) : La frecuencia con la que se añade atención cruzada a las capas del Transformer.
encoder_hidden_size (`int`, *opcional*, valor predeterminado 1408) : El tamaño oculto de los estados ocultos para la atención cruzada.
Esta es la clase de configuración para almacenar la configuración de un InstructBlipModel. Se utiliza para instanciar un modelo Instructblip según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplos:
```python
>>> from transformers import InstructBlipQFormerConfig, InstructBlipQFormerModel
>>> # Initializing a InstructBLIP Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipQFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipProcessor[[transformers.InstructBlipProcessor]]
#### transformers.InstructBlipProcessor[[transformers.InstructBlipProcessor]]
```python
transformers.InstructBlipProcessor(image_processor, tokenizer, qformer_tokenizer, num_query_tokens = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/processing_instructblip.py#L30)
**Parámetros:**
image_processor (`BlipImageProcessor`) : El procesador de imágenes es un parámetro de entrada obligatorio.
tokenizer (`GPT2Tokenizer`) : El tokenizador es una entrada obligatoria.
qformer_tokenizer (`AutoTokenizer`) : Una instancia de ['PreTrainedTokenizer`]. El tokenizador Q-Former es una entrada obligatoria.
num_query_tokens (`int`, *opcional*) : "Número de tokens utilizados por el Qformer como consultas, debe ser el mismo que en la configuración del modelo.
Construye un InstructBlipProcessor que envuelve un procesador de imágenes, un tokenizador y un tokenizador de qformer en un único procesador.
[InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor) ofrece todas las funcionalidades de [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor), [GPT2Tokenizer](/docs/transformers/v5.23.0/es/model_doc/gpt2#transformers.GPT2Tokenizer) y `{qformer_tokenizer_class}`. Consulte [~BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor), [~GPT2Tokenizer](/docs/transformers/v5.23.0/es/model_doc/gpt2#transformers.GPT2Tokenizer) y `~{qformer_tokenizer_class}` para obtener más información.
#### __llamada__[[transformers.InstructBlipProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/processing_instructblip.py#L52)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagen para preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : La secuencia o el lote de secuencias que se van a codificar. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas (cadena pretokenizada). Si se pasa una entrada pretokenizada, establezca `is_split_into_words=True` para evitar ambigüedad con las entradas en lote.
return_mm_token_type_ids (`bool`, *kwargs*) : Si se deben devolver los ids de tipo de token multimodal que indican las posiciones de los tokens de marcador multimodal.
return_text_replacement_offsets (`bool`, *kwargs*) : Si se deben devolver los desplazamientos de caracteres para cada marcador de posición multimodal y su reemplazo.
return_tensors (`str` o [TensorType](/docs/transformers/v5.23.0/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/es/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opciones de procesamiento adicionales para cada modalidad (texto, imágenes, vídeos, audio). Los parámetros específicos del modelo se enumeran arriba; consulte la clase TypedDict para obtener la lista completa de argumentos admitidos.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
## InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
#### transformers.InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
```python
transformers.InstructBlipVisionModel(config: InstructBlipVisionConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L392)
#### forward[[transformers.InstructBlipVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L412)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor). Consulte [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor) para procesar imágenes).
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) y las entradas.
El método forward de [InstructBlipVisionModel](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipVisionModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
## InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
#### transformers.InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
```python
transformers.InstructBlipQFormerModel(config: InstructBlipQFormerConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L760)
Querying Transformer (Q-Former), utilizado en InstructBLIP. Se modificó ligeramente respecto a BLIP-2, ya que también toma la instrucción como entrada.
#### forward[[transformers.InstructBlipQFormerModel.forward]]
```python
forward(input_ids: LongTensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, query_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L799)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
query_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Estados ocultos que se utilizarán en el cálculo de la atención. En el caso de atención cruzada, se utilizarán para la consulta (es decir, la clave y el valor usarán encoder_hidden_states).
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Secuencia de estados ocultos en la salida de la última capa del codificador. Se utiliza en la atención cruzada si el modelo está configurado como decodificador.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno de la entrada del codificador. Esta máscara se utiliza en la atención cruzada si el modelo está configurado como decodificador. Valores de máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**.
**Devuelve:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) y las entradas.
El método forward de [InstructBlipQFormerModel](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipQFormerModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` y `config.add_cross_attention=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención de la capa de atención cruzada del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
- **past_key_values** (`Cache`, *opcional*, se devuelve cuando se pasa `use_cache=True` o cuando `config.use_cache=True`) -- Es una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache). Para más detalles, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contiene estados ocultos precalculados (claves y valores en los bloques de autoatención y, opcionalmente, si `config.is_encoder_decoder=True`, en los bloques de atención cruzada) que pueden utilizarse (véase la entrada `past_key_values`) para acelerar la decodificación secuencial.
## InstructBlipModel[[transformers.InstructBlipModel]]
#### transformers.InstructBlipModel[[transformers.InstructBlipModel]]
```python
transformers.InstructBlipModel(config: InstructBlipConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L867)
**Parámetros:**
config ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo base de InstructBLIP que consta de un modelo de lenguaje, un qformer y un codificador de visión.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.InstructBlipModel.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L919)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor). Consulte [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor) para procesar imágenes).
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario del Q-Former. Se pueden proporcionar opcionalmente tokens de entrada para servir como prompt de texto, que el modelo Q-Former codificará. Los índices se pueden obtener usando [InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor). Consulte [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para obtener más detalles. [¿Qué son los input IDs?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada del decodificador en el vocabulario. Los índices se pueden obtener usando [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para más detalles. [¿Qué son los IDs de entrada del decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamiento predeterminado: genera un tensor que ignora los tokens de relleno en `decoder_input_ids`. También se usará una máscara causal de forma predeterminada. Solo es relevante en el caso de que se utilice un modelo de lenguaje codificador-decodificador (como T5).
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `InstructBlipForConditionalGenerationModelOutput` o `tuple(torch.Tensor)`
Un `InstructBlipForConditionalGenerationModelOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) y las entradas.
El método forward de [InstructBlipModel](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, se devuelve cuando se proporciona `labels`, `torch.Tensor` de forma `(1,)`) -- Pérdida de modelado de lenguaje del modelo de lenguaje.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje del modelo de lenguaje.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Salidas del codificador de visión.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Salidas del Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` o `Seq2SeqLMOutput`) -- Salidas del modelo de lenguaje.
#### get_placeholder_mask[[transformers.InstructBlipModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L904)
Obtiene la máscara de marcador de posición multimodal a partir de `input_ids` o `inputs_embeds`.
## InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
#### transformers.InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
```python
transformers.InstructBlipForConditionalGeneration(config: InstructBlipConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1028)
**Parámetros:**
config ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo InstructBLIP para generar texto a partir de una imagen y un prompt de texto opcional. El modelo consta de un codificador de visión, un Querying Transformer (Q-Former) y un modelo de lenguaje.
Opcionalmente, se puede pasar `input_ids` al modelo, que actúa como un texto de indicación, para que el modelo de lenguaje continúe la indicación. De lo contrario, el modelo de lenguaje comienza a generar texto desde el token [BOS] (inicio de secuencia).
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.InstructBlipForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1174)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor). Consulte [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor) usa [BlipImageProcessor](/docs/transformers/v5.23.0/es/model_doc/blip#transformers.BlipImageProcessor) para procesar imágenes).
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario del Q-Former. Se pueden proporcionar opcionalmente tokens de entrada para servir como prompt de texto, que el modelo Q-Former codificará. Los índices se pueden obtener usando [InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor). Consulte [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para obtener más detalles. [¿Qué son los input IDs?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada del decodificador en el vocabulario. Los índices se pueden obtener usando [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para más detalles. [¿Qué son los IDs de entrada del decodificador?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forma `(batch_size, target_sequence_length)`, *opcional*) : Comportamiento predeterminado: genera un tensor que ignora los tokens de relleno en `decoder_input_ids`. También se usará una máscara causal de forma predeterminada. Solo es relevante en el caso de que se utilice un modelo de lenguaje codificador-decodificador (como T5).
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de modelado de lenguaje. Los índices deben estar en `[-100, 0, ..., config.vocab_size - 1]`. Todas las etiquetas establecidas en `-100` se ignoran (se enmascaran); la pérdida solo se calcula para las etiquetas en `[0, ..., config.vocab_size]`
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opcional*) : Diccionario donde las claves son las modalidades admitidas y los valores son las salidas codificadas para esa modalidad. Cada salida codificada es una tupla que consiste en (`pooler_output`, *opcional*: `last_hidden_states`, *opcional*: `hidden_states`, *opcional*: `attentions`) `pooler_output` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) es una secuencia de características multimodales del codificador fusionadas en las incrustaciones de texto.
**Devuelve:** `InstructBlipForConditionalGenerationModelOutput` o `tuple(torch.Tensor)`
Un `InstructBlipForConditionalGenerationModelOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) y las entradas.
El método forward de [InstructBlipForConditionalGeneration](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipForConditionalGeneration) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor`, *opcional*, se devuelve cuando se proporciona `labels`, `torch.Tensor` de forma `(1,)`) -- Pérdida de modelado de lenguaje del modelo de lenguaje.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje del modelo de lenguaje.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Salidas del codificador de visión.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Salidas del Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` o `Seq2SeqLMOutput`) -- Salidas del modelo de lenguaje.
Ejemplos:
```python
>>> from transformers import InstructBlipProcessor, InstructBlipForConditionalGeneration
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> processor = InstructBlipProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model.to(device)
>>> url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/lavis_confusing_pictures.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> prompt = "What is unusual about this image?"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)
>>> outputs = model.generate(
... **inputs,
... do_sample=False,
... num_beams=5,
... max_length=256,
... min_length=1,
... top_p=0.9,
... repetition_penalty=1.5,
... length_penalty=1.0,
... temperature=1,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
The unusual aspect of this image is that a man is ironing clothes on the back of a yellow SUV, which is parked in the middle of a busy city street. This is an unconventional approach to ironing clothes, as it requires the man to balance himself and his ironing equipment on top of the vehicle while navigating through traffic. Additionally, the presence of taxis and other vehicles in the scene further emphasizes the unusual nature of this situation.
```
#### generate[[transformers.InstructBlipForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, qformer_input_ids: typing.Optional[torch.LongTensor] = None, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1313)
**Parámetros:**
pixel_values (`torch.Tensor` de forma (batch_size, num_channels, height, width)) : Imágenes de entrada a procesar.
qformer_input_ids (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : La secuencia utilizada como indicación para alimentar al módulo Q-Former.
qformer_attention_mask (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno.
input_ids (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : La secuencia utilizada como indicación para la generación.
attention_mask (`torch.LongTensor` de forma (batch_size, sequence_length), *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) : Representación incrustada de las entradas. Debe ser de tipo float, no tokens int.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar la codificación posicional de las incrustaciones de imagen.
**Devuelve:** `captions (list)`
Una lista de cadenas de longitud batch_size * num_captions.
Sobrescribe la función `generate` para poder usar el modelo como generador condicional.
#### get_image_features[[transformers.InstructBlipForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, qformer_input_ids: LongTensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1091)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada.
qformer_input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario del Q-Former. Se pueden proporcionar opcionalmente tokens de entrada para servir como prompt de texto, que el modelo Q-Former codificará. Los índices se pueden obtener usando [InstructBlipProcessor](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor). Consulte [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) para obtener más detalles. [¿Qué son los input IDs?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `BaseModelOutputWithVisionQformerOutputs` o `tuple(torch.Tensor)`
Un `BaseModelOutputWithVisionQformerOutputs` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([InstructBlipConfig](/docs/transformers/v5.23.0/es/model_doc/instructblip#transformers.InstructBlipConfig)) y las entradas.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa del primer token de la secuencia (token de clasificación) después de un procesamiento adicional a través de las capas utilizadas para la tarea de preentrenamiento auxiliar. Por ejemplo, para la familia de modelos BERT, esto devuelve el token de clasificación después de procesarlo a través de una capa lineal y una función de activación tanh. Los pesos de la capa lineal se entrenan a partir del objetivo de predicción de la siguiente oración (clasificación) durante el preentrenamiento.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *opcional*) -- Salidas del codificador de visión.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *opcional*) -- Salidas del Q-Former (Querying Transformer).
Ejemplo:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipForConditionalGeneration
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```