
Transformers documentation
GLM-4.5, GLM-4.6, GLM-4.7
Ce modèle a été publié dans HF papers le 2025-08-08 et contribué à Hugging Face Transformers le 2025-07-21.
GLM-4.5, GLM-4.6, GLM-4.7
Aperçu
Les modèles de langage GLM-4.7, GLM-4.6 et GLM-4.5 utilisent cette classe. L’implémentation dans transformers n’inclut pas de couche MTP.
GLM-4.7
GLM-4.7, votre nouveau partenaire de codage, arrive avec les fonctionnalités suivantes :
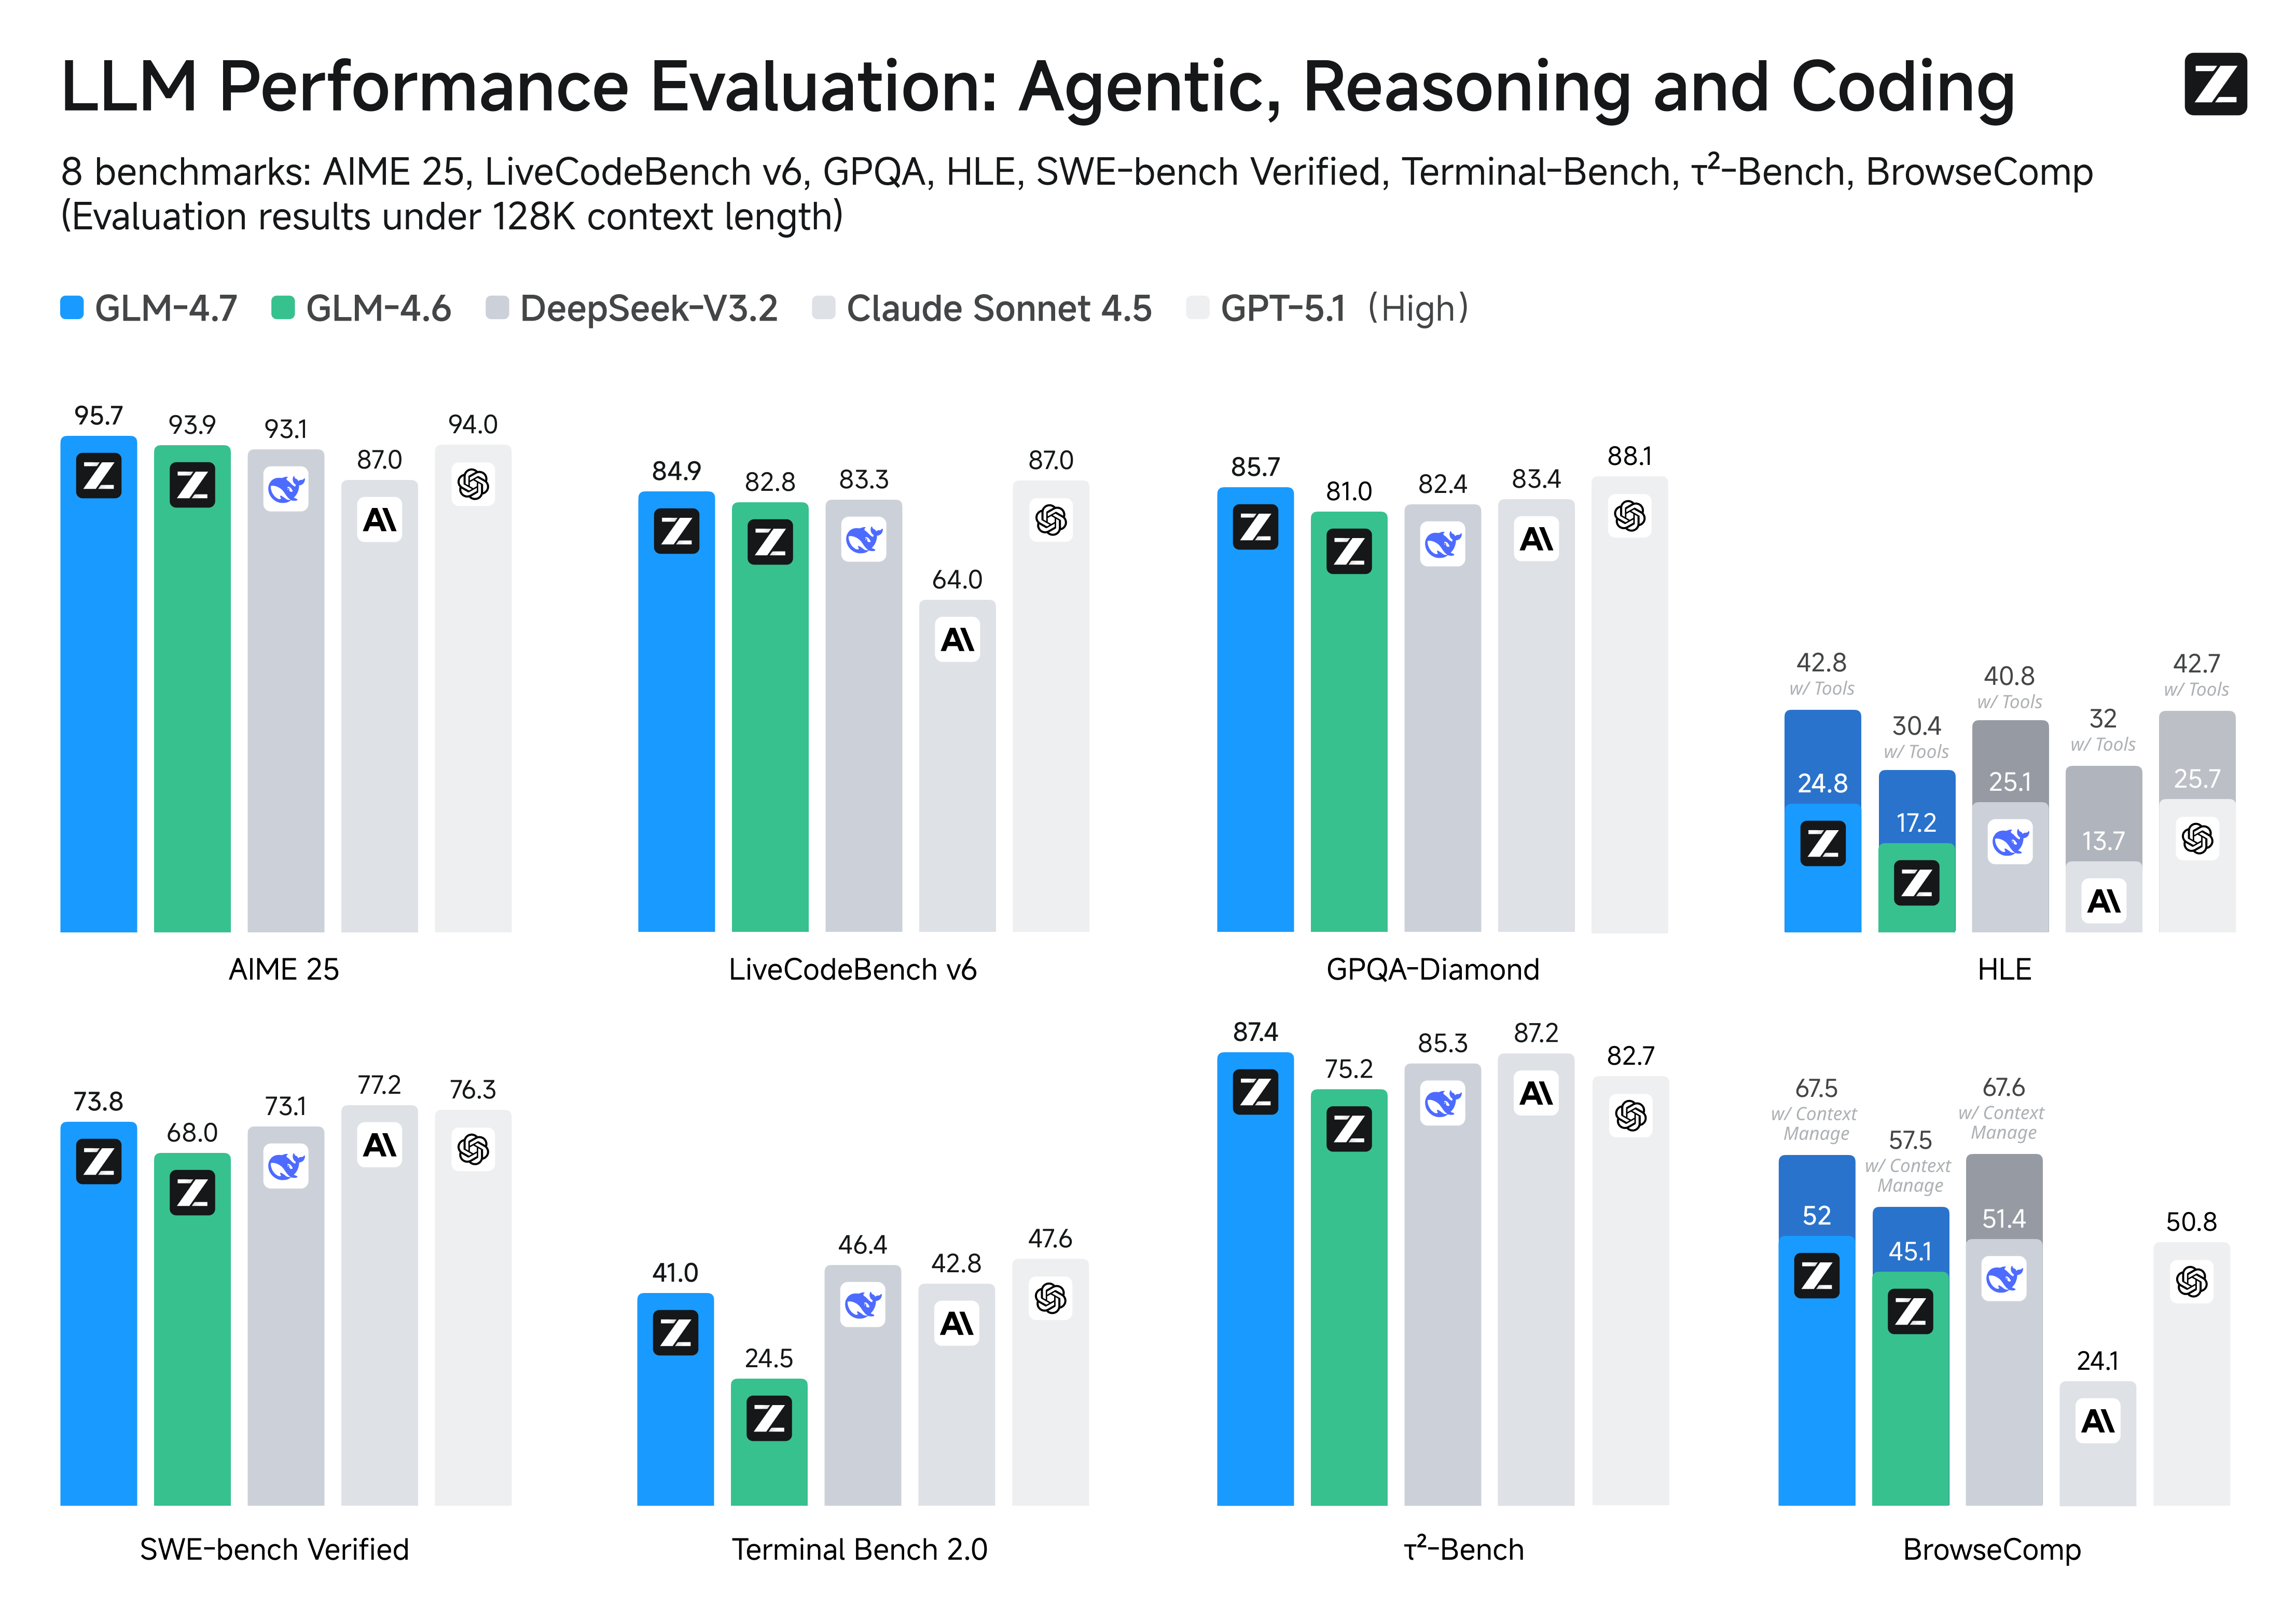
- Codage principal : GLM-4.7 apporte des gains clairs, par rapport à son prédécesseur GLM-4.6, en codage agentique multilingue et en tâches basées sur le terminal, notamment (73,8 %, +5,8 %) sur SWE-bench, (66,7 %, +12,9 %) sur SWE-bench Multilingual et (41 %, +16,5 %) sur Terminal Bench 2.0. GLM-4.7 prend également en charge la réflexion avant l'action, avec des améliorations significatives sur les tâches complexes dans les frameworks d'agents mainstream tels que Claude Code, Kilo Code, Cline et Roo Code.
- Vibe Coding : GLM-4.7 franchit un grand pas en avant en améliorant la qualité des interfaces utilisateur. Il génère des pages web plus propres et modernes, ainsi que des diapositives plus esthétiques, avec un agencement et un dimensionnement plus précis.
- Utilisation d’outils : GLM-4.7 obtient des améliorations significatives en matière d’utilisation d’outils. Des performances nettement supérieures sont observées sur des benchmarks tels que τ^2-Bench et lors de la navigation web via BrowseComp.
- Raisonnement complexe : GLM-4.7 offre une amélioration significative des capacités mathématiques et de raisonnement, atteignant (42,8 %, +12,4 %) sur le benchmark HLE (Humanity’s Last Exam) par rapport à GLM-4.6.
Plus généralement, on observerait également des améliorations significatives dans de nombreux autres scénarios, tels que le chat, l'écriture créative et les scénarios de jeu de rôle.
Pensée entrelacée et pensée préservée
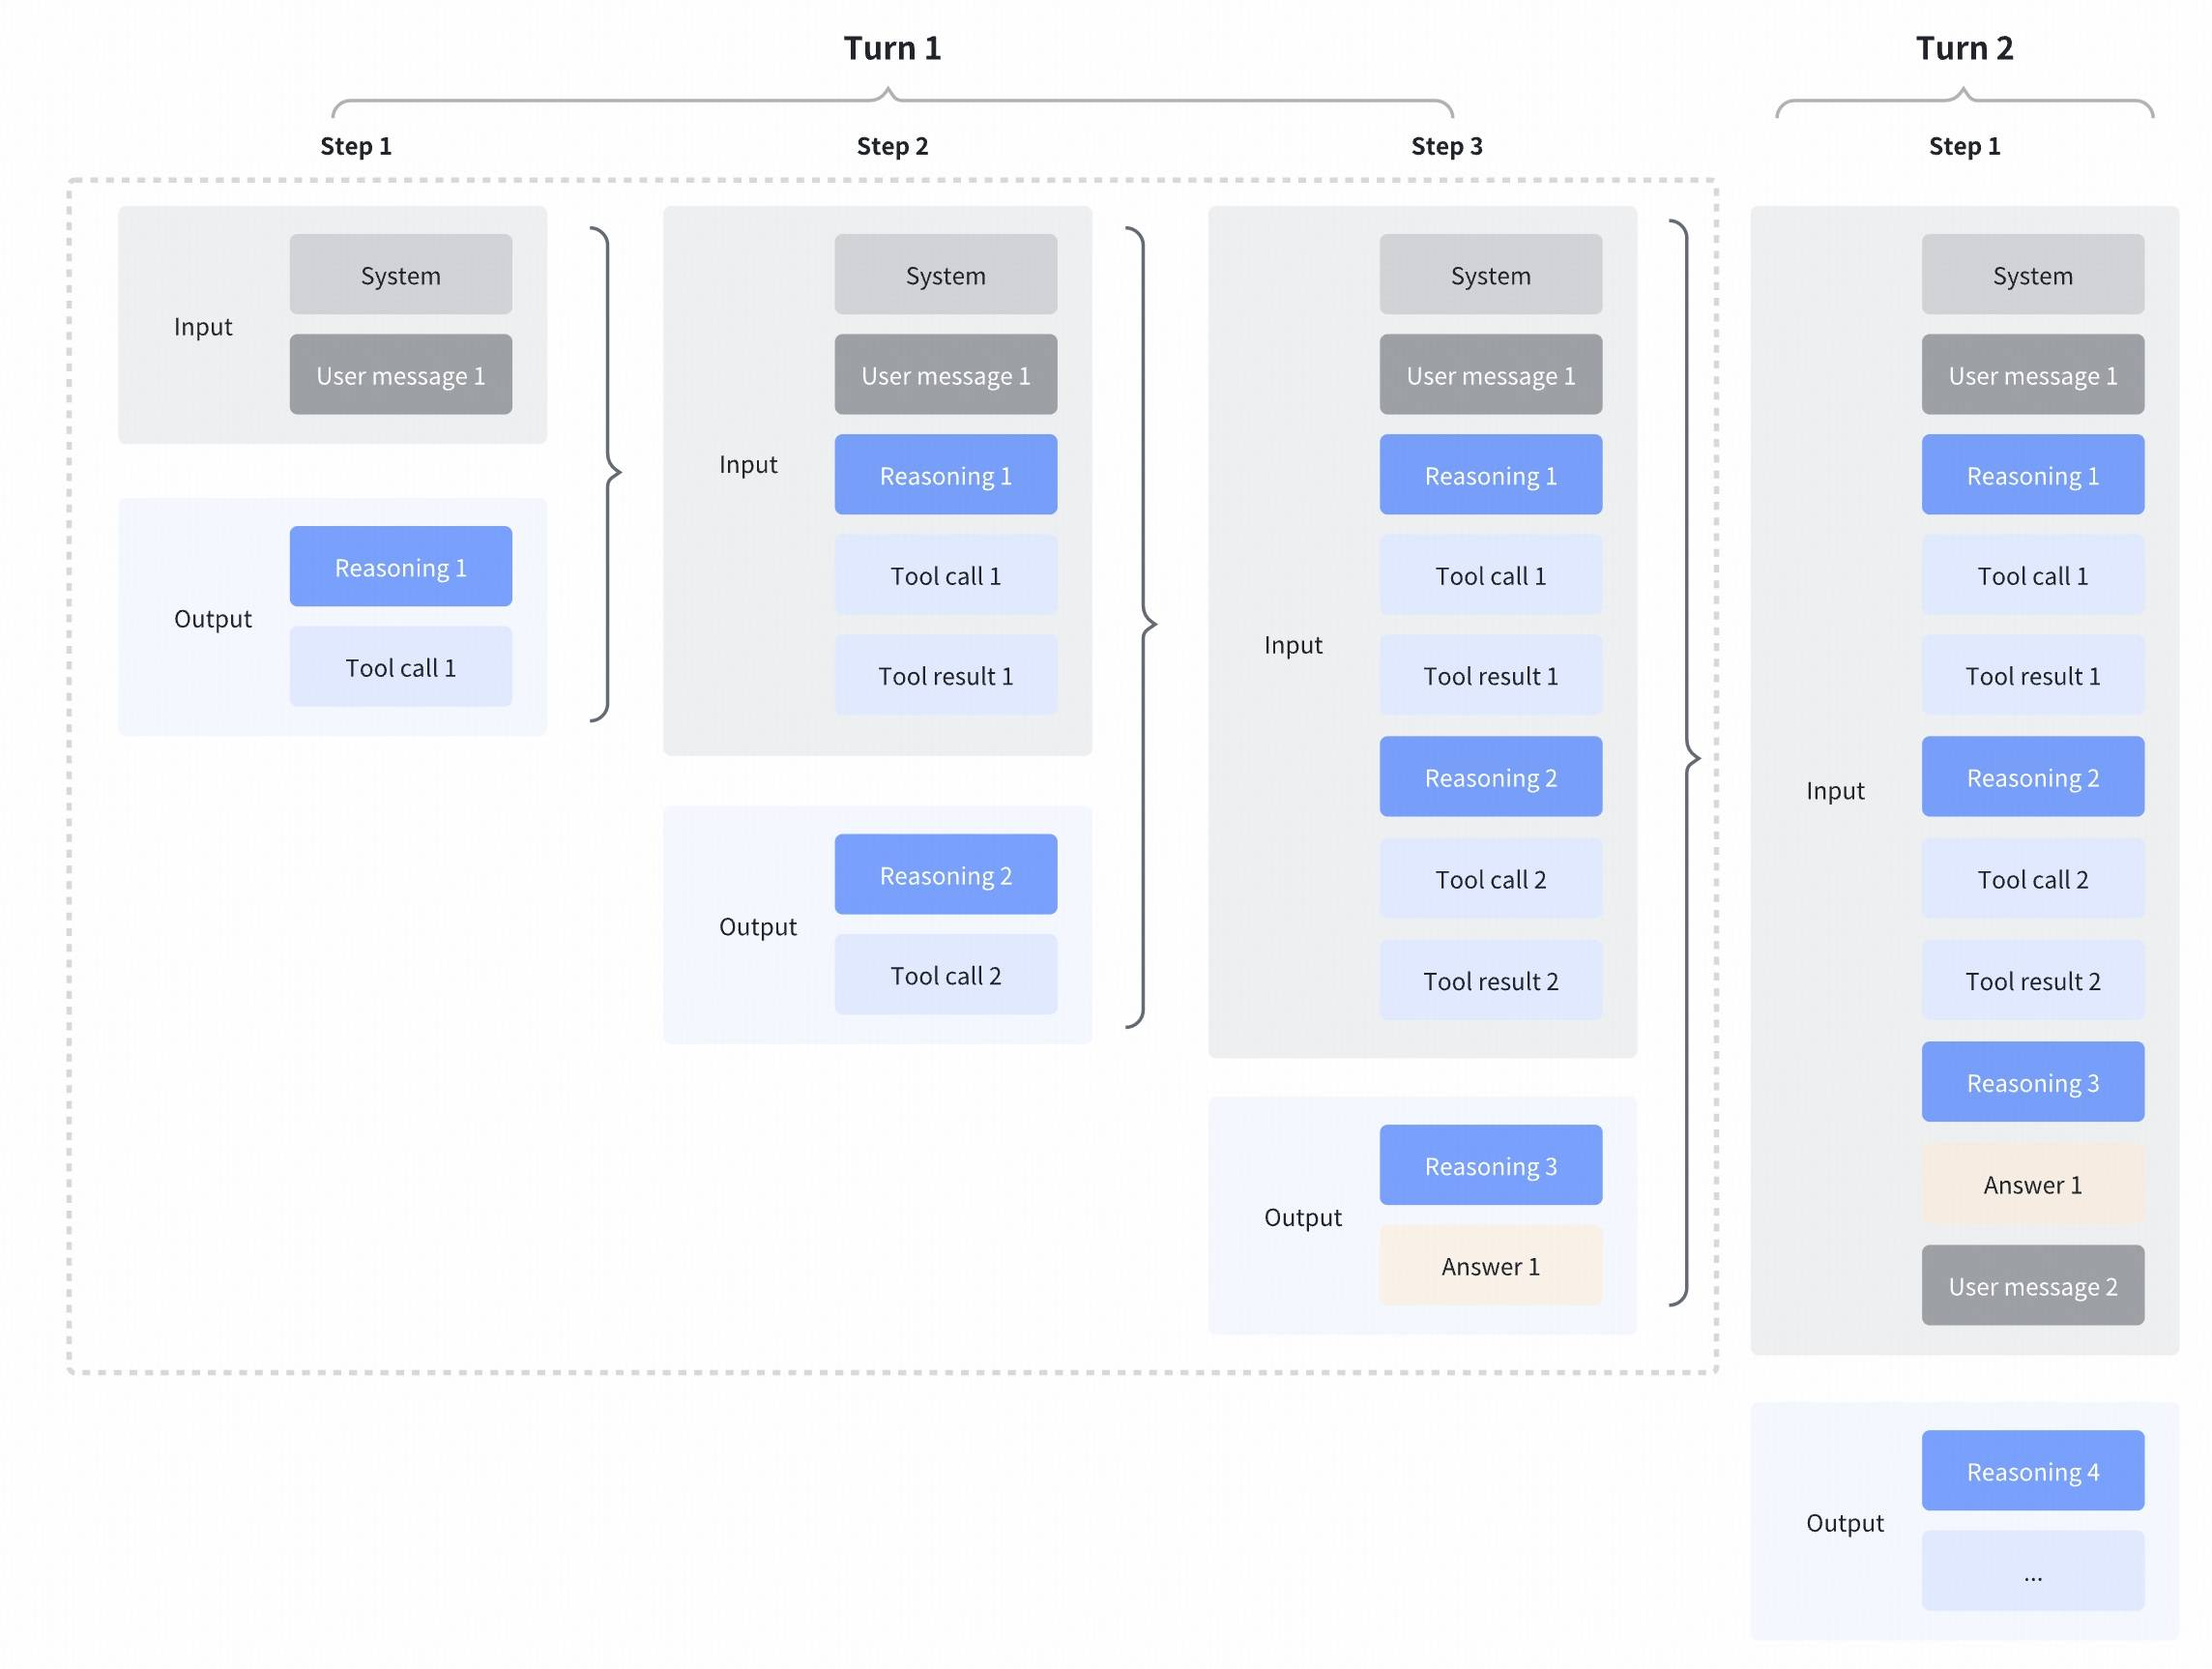
GLM-4.7 améliore davantage Interleaved Thinking (une fonctionnalité introduite depuis GLM-4.5) et présente Preserved Thinking et Turn-level Thinking. En réfléchissant entre les actions et en restant cohérent d'un tour à l'autre, il rend les tâches complexes plus stables et plus contrôlables :
- Raisonnement entrelacé : le modèle réfléchit avant chaque réponse et chaque appel d'outil, ce qui améliore le respect des instructions et la qualité de la génération.
- Pensée préservée : dans les scénarios d’agents de codage, le modèle conserve automatiquement tous les blocs de réflexion au fil des conversations multi-tours, en réutilisant le raisonnement existant plutôt que de le dériver à nouveau depuis zéro. Cela réduit la perte d’informations et les incohérences, et convient bien aux tâches complexes de longue durée.
- Raisonnement par tour : le modèle permet de contrôler le raisonnement à chaque tour au sein d'une session — désactivez le raisonnement pour les requêtes légères afin de réduire la latence et les coûts, et activez-le pour les tâches complexes afin d'améliorer la précision et la stabilité.
Plus de détails : https://docs.z.ai/guides/capabilities/thinking-mode
Pour plus de résultats d'évaluation, d'exemples d'utilisation et de détails techniques, veuillez consulter le blog technique GLM-4.7.
GLM-4.6
Par rapport à GLM-4.5, GLM-4.6 apporte plusieurs améliorations clés :
- Fenêtre de contexte plus longue : la fenêtre de contexte a été étendue de 128K à 200K jetons, permettant au modèle de traiter des tâches agentiques plus complexes.
- Performances supérieures en programmation : Le modèle obtient des scores plus élevés sur les benchmarks de code et démontre de meilleures performances réelles dans des applications telles que Claude Code, Cline, Roo Code et Kilo Code, notamment en générant des pages front-end visuellement soignées.
- Raisonnement avancé : GLM-4.6 présente une amélioration nette des performances de raisonnement et prend en charge l'utilisation d'outils lors de l'inférence, ce qui renforce ses capacités globales.
- Des agents plus performants : GLM-4.6 présente de meilleures performances dans les agents utilisant des outils et basés sur la recherche, et s'intègre plus efficacement dans les frameworks d'agents.
- Rédaction affinée : Meilleure adéquation aux préférences humaines en matière de style et de lisibilité, et comportement plus naturel dans les scénarios de jeu de rôle.
Nous avons évalué GLM-4.6 sur huit benchmarks publics couvrant les agents, le raisonnement et le codage. Les résultats montrent des gains clairs par rapport à GLM-4.5, GLM-4.6 conservant également des avantages concurrentiels face à des modèles nationaux et internationaux de pointe tels que DeepSeek-V3.1-Terminus et Claude Sonnet 4.
Pour plus de résultats d'évaluation, d'exemples d'utilisation et de détails techniques, veuillez consulter le blog technique GLM-4.6.
GLM-4.5
Les modèles de la série GLM-4.5 sont des modèles de base conçus pour les agents intelligents ; les variantes MoE sont documentées ici sous le nom Glm4Moe.
GLM-4.5 dispose de 355 milliards de paramètres au total, dont 32 milliards de paramètres actifs, tandis que GLM-4.5-Air adopte une conception plus compacte avec 106 milliards de paramètres au total et 12 milliards de paramètres actifs. Les modèles GLM-4.5 unissent les capacités de raisonnement, de codage et d’agent intelligent pour répondre aux exigences complexes des applications d’agents intelligents.
GLM-4.5 et GLM-4.5-Air sont tous deux des modèles de raisonnement hybrides qui offrent deux modes : le mode de raisonnement pour le raisonnement complexe et l'utilisation d'outils, et le mode non-raisonnement pour des réponses immédiates.
Nous avons publié en open source les modèles de base, les modèles de raisonnement hybride et les versions FP8 des modèles de raisonnement hybride pour GLM-4.5 et GLM-4.5-Air. Ils sont publiés sous licence open source MIT et peuvent être utilisés à des fins commerciales et pour le développement secondaire.
Comme le montre notre évaluation complète sur 12 benchmarks de référence de l’industrie, GLM-4.5 atteint des performances exceptionnelles avec un score de 63,2, se classant 3e parmi tous les modèles propriétaires et open source. Notons que GLM-4.5-Air offre des résultats compétitifs à 59,8 tout en conservant une efficacité supérieure.
Pour plus de résultats d'évaluation, d'exemples concrets et de détails techniques, veuillez consulter notre rapport technique ou notre blog technique.
Le code du modèle, l'analyseur d'outils et l'analyseur de raisonnement peuvent être trouvés dans l'implémentation de transformers, vLLM et SGLang.
Glm4MoeConfig
classe transformers.Glm4MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 151552hidden_size: int = 4096intermediate_size: int = 10944num_hidden_layers: int = 46num_attention_heads: int = 96num_key_value_heads: int = 8hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Falserope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0moe_intermediate_size: int = 1408num_experts_per_tok: int = 8output_router_logits: bool = Falsen_shared_experts: int = 1n_routed_experts: int = 128routed_scaling_factor: float = 1.0n_group: int = 1topk_group: int = 1first_k_dense_replace: int = 1norm_topk_prob: bool = Trueuse_qk_norm: bool = Falsebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepad_token_id: int | None = Nonenum_mtp_layers: int = 1 )
Paramètres
- vocab_size (
int, facultatif, par défaut151552) — Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés parinput_ids. - hidden_size (
int, facultatif, par défaut4096) — Dimension des représentations cachées. - intermediate_size (
int, facultatif, par défaut10944) — Dimension des représentations du MLP. - num_hidden_layers (
int, facultatif, par défaut46) — Nombre de couches cachées dans le décodeur Transformer. - num_attention_heads (
int, facultatif, valeur par défaut96) — Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer. - num_key_value_heads (
int, facultatif, valeur par défaut8) — Ceci est le nombre de têtes key_value à utiliser pour implémenter l'attention Grouped Query. Sinum_key_value_heads=num_attention_heads, le modèle utilisera l'attention Multi Head (MHA), sinum_key_value_heads=1le modèle utilisera l'attention Multi Query (MQA), sinon l'attention GQA est utilisée. Lors de la conversion d'un checkpoint multi-têtes en checkpoint GQA, chaque tête clé et valeur de groupe doit être construite en effectuant un meanpooling de toutes les têtes d'origine au sein de ce groupe. Pour plus de détails, consultez ce papier. S'il n'est pas spécifié, la valeur par défaut seranum_attention_heads. - hidden_act (
str, facultatif, par défautsilu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple,"gelu","relu","silu", etc. - max_position_embeddings (
int, facultatif, par défaut131072) — La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé. - initializer_range (
float, facultatif, par défaut0.02) — L'écart-type de la truncated_normal_initializer utilisé pour initialiser toutes les matrices de poids. - rms_norm_eps (
float, facultatif, valeur par défaut1e-05) — L'épsilon utilisé par les couches de normalisation rms. - use_cache (
bool, facultatif, valeur par défautTrue) — Indique si le modèle doit retourner les dernières attentions clés/valeurs (non utilisé par tous les modèles). N’est pertinent que siconfig.is_decoder=Trueou si le modèle est un modèle génératif uniquement décodeur. - tie_word_embeddings (
bool, facultatif, valeur par défautFalse) — Indique s'il faut lier les embeddings de poids selon la correspondancetied_weights_keysdu modèle. - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], facultatif) — Dictionnaire contenant les paramètres de configuration pour les embeddings RoPE. Le dictionnaire doit contenir une valeur pourrope_thetaet, le cas échéant, les paramètres utilisés pour le mise à l’échelle si vous souhaitez utiliser RoPE avec desmax_position_embeddingsplus longs. - attention_bias (
bool, facultatif, par défautFalse) — Indique s'il faut utiliser un biais dans les couches de projection des requêtes, des clés, des valeurs et de la sortie lors de l'auto-attention. - attention_dropout (
Union[float, int], facultatif, valeur par défaut0.0) — Le taux de dropout appliqué aux probabilités d'attention. - moe_intermediate_size (
int, facultatif, par défaut1408) — Taille intermédiaire des MLP des experts routés. - num_experts_per_tok (
int, facultatif, valeur par défaut8) — Nombre d'experts auxquels chaque jeton doit être routé. Il s'agit de la valeur top-k pour le routage par choix de jeton. - output_router_logits (
bool, facultatif, par défautFalse) — Indique si les logits du routeur doivent être renvoyés par le modèle. L’activation de cette option permet également au modèle de renvoyer la perte auxiliaire, incluant la perte d’équilibrage de charge et la perte z du routeur. - n_shared_experts (
int, facultatif, par défaut1) — Nombre d'experts partagés. - n_routed_experts (
int, facultatif, par défaut128) — Nombre d'experts routés. - routed_scaling_factor (
float, facultatif, par défaut1.0) — Facteur d'échelle des experts routés. - n_group (
int, facultatif, valeur par défaut 1) — Nombre de groupes pour les experts routés. - topk_group (
int, facultatif, valeur par défaut1) — Nombre de groupes sélectionnés pour chaque jeton (pour chaque jeton, garantissant que les experts sélectionnés ne se trouvent que danstopk_groupgroupes). - first_k_dense_replace (
int, facultatif, valeur par défaut 1) — Nombre de couches denses dans les couches superficielles (embed->dense->dense->…->dense->moe->moe…->lm_head). --k couches denses—/ - norm_topk_prob (
bool, facultatif, valeur par défautTrue) — Indique s'il faut normaliser les poids des experts routés. - use_qk_norm (
bool, facultatif, valeur par défautFalse) — Indique s'il faut utiliser la normalisation des requêtes et des clés dans l'attention. - bos_token_id (
int, facultatif) — Identifiant du jeton utilisé pour le début de flux dans le vocabulaire. - eos_token_id (
Union[int, list[int]], facultatif) — Identifiant du jeton utilisé pour la fin de flux dans le vocabulaire. - pad_token_id (
int, facultatif) — Identifiant du jeton utilisé pour le bourrage dans le vocabulaire. - num_mtp_layers (
int, facultatif, valeur par défaut 1) — Nombre de modules de prédiction multi-tokens (MTP) disponibles à ajouter après le modèle transformer de base. Si la valeur est0, le modèle se comporte comme un décodeur standard. Si la valeur est>0, chaque module supplémentaire peut prédire un token futur supplémentaire au moment de l'inférence (décodage spéculatif viagenerate(..., use_mtp=True)).
Ceci est la classe de configuration destinée à stocker la configuration d'un Glm4MoeModel. Elle est utilisée pour instancier un modèle Glm4 Moe en fonction des arguments spécifiés, définissant ainsi l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de zai-org/GLM-4.5
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import Glm4MoeModel, Glm4MoeConfig

>>> # Initializing a Glm4Moe style configuration
>>> configuration = Glm4MoeConfig()

>>> # Initializing a model from the GLM-4-MOE-100B-A10B style configuration
>>> model = Glm4MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Glm4MoeModel
classe transformers.Glm4MoeModel
< source >( config: Glm4MoeConfig )
Paramètres
- config (Glm4MoeConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle Glm4 Moe brut, produisant des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Paramètres
- input_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut.Les indices peuvent être obtenus à l'aide de AutoTokenizer. Consultez PreTrainedTokenizer.encode() et PreTrainedTokenizer.call() pour plus de détails.
- attention_mask (
torch.Tensorde forme(batch_size, sequence_length), facultatif) — Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans[0, 1]:- 1 pour les jetons qui ne sont pas masqués,
- 0 pour les jetons masqués.
- position_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, facultatif) — États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Cela consiste généralement en lapast_key_valuesretournée par le modèle à une étape antérieure du décodage, lorsqueuse_cache=Trueouconfig.use_cache=True.Seule une instance de Cache est autorisée en entrée, consultez notre guide du cache kv. Si aucun
past_key_valuesn'est transmis, DynamicCache sera initialisé par défaut.Le modèle produira le même format de cache qui est fourni en entrée.
Si
past_key_valuessont utilisés, l’utilisateur doit fournir uniquement lesinput_idsnon traités (ceux pour lesquels les états de clés et de valeurs passées n’ont pas été fournis à ce modèle) de forme(batch_size, unprocessed_length)au lieu de tous lesinput_idsde forme(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forme(batch_size, sequence_length, hidden_size), facultatif) — Facultativement, au lieu de passerinput_ids, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indicesinput_idsen vecteurs associés que la matrice de recherche d’intégration interne du modèle. - use_cache (
bool, facultatif) — Si défini surTrue, les états clé-valeurpast_key_valuessont renvoyés et peuvent être utilisés pour accélérer le décodage (voirpast_key_values).
Retourne
MoeModelOutputWithPast ou tuple(torch.Tensor)
Un MoeModelOutputWithPast ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (Glm4MoeConfig) et des entrées.
La méthode forward du modèle Glm4MoeModel redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.past_key_values (
Cache, facultatif, renvoyé lorsqueuse_cache=Trueest passé ou lorsqueconfig.use_cache=True) — Il s’agit d’une instance de Cache. Pour plus de détails, consultez notre guide sur le cache kv.Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention et, le cas échéant, si
config.is_encoder_decoder=True, dans les blocs d'attention croisée) qui peuvent être utilisés (voir l'entréepast_key_values) pour accélérer le décodage séquentiel.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
router_logits (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_router_probs=Trueetconfig.add_router_probs=Truesont passés ou lorsqueconfig.output_router_probs=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, sequence_length, num_experts).Logits bruts du routeur (après softmax) calculés par les routeurs MoE, ces termes sont utilisés pour calculer la perte auxiliaire des modèles Mixture of Experts.
Glm4MoeForCausalLM
classe transformers.Glm4MoeForCausalLM
< source >( config: Glm4MoeConfig )
Paramètres
- config (Glm4MoeConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle Glm4 Moe pour la modélisation de langage causale.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Paramètres
- input_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut.Les indices peuvent être obtenus à l'aide de AutoTokenizer. Consultez PreTrainedTokenizer.encode() et PreTrainedTokenizer.call() pour plus de détails.
- attention_mask (
torch.Tensorde forme(batch_size, sequence_length), facultatif) — Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans[0, 1]:- 1 pour les jetons qui ne sont pas masqués,
- 0 pour les jetons masqués.
- position_ids (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, facultatif) — États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Cela consiste généralement en lapast_key_valuesretournée par le modèle à une étape antérieure du décodage, lorsqueuse_cache=Trueouconfig.use_cache=True.Seule une instance de Cache est autorisée en entrée, consultez notre guide du cache kv. Si aucun
past_key_valuesn'est transmis, DynamicCache sera initialisé par défaut.Le modèle produira le même format de cache qui est fourni en entrée.
Si
past_key_valuessont utilisés, l’utilisateur doit fournir uniquement lesinput_idsnon traités (ceux pour lesquels les états de clés et de valeurs passées n’ont pas été fournis à ce modèle) de forme(batch_size, unprocessed_length)au lieu de tous lesinput_idsde forme(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forme(batch_size, sequence_length, hidden_size), facultatif) — Facultativement, au lieu de passerinput_ids, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indicesinput_idsen vecteurs associés que la matrice de recherche d’intégration interne du modèle. - labels (
torch.LongTensorde forme(batch_size, sequence_length), facultatif) — Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être dans[0, ..., config.vocab_size]ou -100 (voir la docstring deinput_ids). Les jetons dont l'indice est défini sur-100sont ignorés (masqués), la perte n'est calculée que pour les jetons dont l'étiquette est dans[0, ..., config.vocab_size]. - use_cache (
bool, facultatif) — Si défini surTrue, les états clé-valeurpast_key_valuessont renvoyés et peuvent être utilisés pour accélérer le décodage (voirpast_key_values). - logits_to_keep (
Union[int, torch.Tensor], facultatif, valeur par défaut0) — Si c'est unint, calcule les logits pour leslogits_to_keepderniers jetons. Si0, calcule les logits pour tous lesinput_ids(cas particulier). Seuls les logits du dernier jeton sont nécessaires pour la génération, et les calculer uniquement pour ce jeton peut économiser de la mémoire, ce qui devient assez significatif pour les séquences longues ou les tailles de vocabulaire importantes. Si c'est untorch.Tensor, il doit être 1D et correspondre aux indices à conserver dans la dimension de la longueur de la séquence. Cela est utile lors de l'utilisation du format de tenseurs empilés (une seule dimension pour le lot et la longueur de la séquence).
Retourne
MoeCausalLMOutputWithPast ou tuple(torch.Tensor)
Un MoeCausalLMOutputWithPast ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (Glm4MoeConfig) et des entrées.
La méthode forward de Glm4MoeForCausalLM redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
loss (
torch.Tensorde forme(1,), facultatif, renvoyé lorsquelabelsest fourni) — Perte de modélisation du langage (pour la prédiction du jeton suivant).logits (
torch.Tensorde forme(batch_size, sequence_length, config.vocab_size)) — Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).aux_loss (
torch.Tensor, facultatif, renvoyé lorsqueoutput_router_logits=Trueest passé ou lorsqueconfig.output_router_logits=True, et que le modèle entraîne son routeur avec une perte d’équilibrage de charge) — Perte auxiliaire d’équilibrage de charge pour les modules creux. Les modèles qui équilibrent leurs experts au moyen d’un biais de routeur à la place (DeepSeek-V3 et les architectures dérivées de celui-ci) renvoientNoneici tout en renvoyant toujoursrouter_logits.router_logits (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_router_logits=Trueest passé ou lorsqueconfig.output_router_logits=True) — Tuple detorch.Tensor(un pour chaque couche creuse) de forme(batch_size * sequence_length, num_experts).Logits bruts du routeur calculés par les routeurs MoE. Ils peuvent être utilisés pour calculer une perte d'équilibrage de charge ou pour inspecter la manière dont les jetons sont acheminés vers les experts.
past_key_values (
Cache, facultatif, renvoyé lorsqueuse_cache=Trueest passé ou lorsqueconfig.use_cache=True) — Il s’agit d’une instance de Cache. Pour plus de détails, consultez notre guide sur le cache kv.Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée
past_key_values) pour accélérer le décodage séquentiel.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
>>> from transformers import AutoTokenizer, Glm4MoeForCausalLM

>>> model = Glm4MoeForCausalLM.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."