
Transformers documentation
PoolFormer
Эта модель была опубликована в HF papers 22.11.2021 и добавлена в Hugging Face Transformers 17.02.2022.
PoolFormer
Обзор
The PoolFormer model was proposed in MetaFormer is Actually What You Need for Vision by Sea AI Labs. Instead of designing complicated token mixer to achieve SOTA performance, the target of this work is to demonstrate the competence of transformer models largely stem from the general architecture MetaFormer.
Аннотация из статьи следующая:
Модели Transformers продемонстрировали большой потенциал в задачах компьютерного зрения. Считается, что именно модуль смешивания токенов на основе механизма внимания вносит наибольший вклад в их эффективность. Однако недавние работы показывают, что модуль на основе внимания в transformers можно заменить пространственными MLP, и полученные модели по-прежнему демонстрируют достаточно высокую производительность. Исходя из этого наблюдения, мы выдвигаем гипотезу о том, что для производительности модели важнее общая архитектура transformers, а не конкретный модуль смешивания токенов. Для проверки этой гипотезы мы намеренно заменяем модуль внимания в transformers на предельно простой оператор пространственного пулинга, выполняющий лишь самое базовое смешивание токенов. Удивительно, но мы наблюдаем, что полученная модель, названная PoolFormer, достигает конкурентоспособных результатов в нескольких задачах компьютерного зрения. Например, на ImageNet-1K PoolFormer достигает точности top-1 82,1%, превосходя хорошо настроенные базовые модели в стиле vision transformer/MLP — DeiT-B/ResMLP-B24 — на 0,3%/1,1% по точности при меньшем количестве параметров на 35%/52% и меньшем количестве MACs на 48%/60%. Эффективность PoolFormer подтверждает нашу гипотезу и побуждает нас ввести понятие «MetaFormer» — общую архитектуру, абстрагированную от transformers без указания конкретного модуля смешивания токенов. На основании обширных экспериментов мы утверждаем, что именно MetaFormer является ключевым фактором достижения превосходных результатов в последних моделях в стиле transformer и MLP на задачах компьютерного зрения. Данная работа призывает к проведению дальнейших исследований, направленных на совершенствование MetaFormer, а не на фокусировку на модулях смешивания токенов. Кроме того, предложенная нами PoolFormer может служить отправной базовой моделью для будущего проектирования архитектур MetaFormer.
На рисунке ниже представлена архитектура PoolFormer. Источник — оригинальная статья.
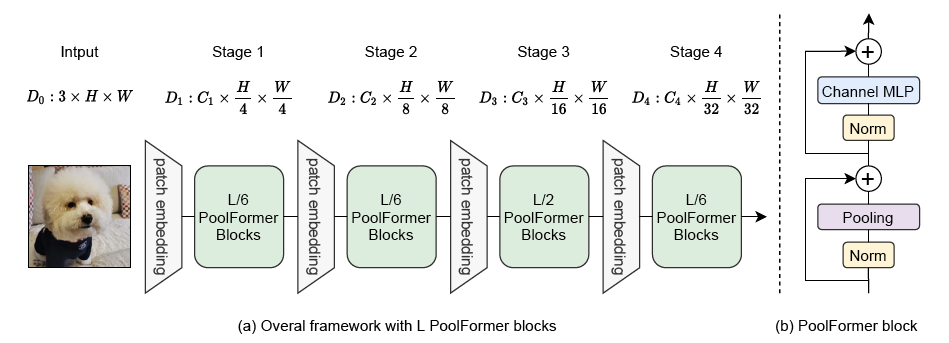
Эта модель была предоставлена пользователем heytanay. Исходный код можно найти здесь.
Советы по использованию
- PoolFormer имеет иерархическую архитектуру, в которой вместо Attention используется простой слой Average Pooling. Все контрольные точки модели можно найти на hub.
- Для подготовки изображений к модели можно использовать PoolFormerImageProcessor.
- Как и большинство моделей, PoolFormer выпускается в разных размерах, подробности о которых приведены в таблице ниже.
| Вариант модели | Глубины | Размеры скрытых слоёв | Параметры (млн) | ImageNet-1k Top 1 |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с PoolFormer.
- PoolFormerForImageClassification поддерживается в этом ноутбуке.
- См. также: Руководство по задаче классификации изображений
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать уже имеющийся.
PoolFormerConfig
класс transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
Параметры
- num_channels (
int, необязательный, по умолчанию3) — Количество входных каналов. - patch_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию16) — Размер (разрешение) каждого патча. - stride (
int, необязательный, по умолчанию 16) — Шаг входного патча. - pool_size (
int, необязательный, по умолчанию 3) — Размер окна пулинга. - mlp_ratio (
float, необязательный, по умолчанию4.0) — Соотношение скрытого размера MLP к размеру эмбеддинга. - depths (
Union[list[int], tuple[int, ...]], необязательный, по умолчанию(2, 2, 6, 2)) — Глубина каждого слоя в Transformer. - hidden_sizes (
Union[list[int], tuple[int, ...]], необязательный, по умолчанию(64, 128, 320, 512)) — Размерность (скрытый размер) на каждом этапе модели. - patch_sizes (
list, необязательный, по умолчанию[7, 3, 3, 3]) — Размер входного патча для каждого блока кодировщика. - strides (
list, необязательный, по умолчанию[4, 2, 2, 2]) — Шаг входного патча для каждого блока кодировщика. - padding (
list, необязательный, по умолчанию[2, 1, 1, 1]) — Отступы входного патча для каждого блока кодировщика. - num_encoder_blocks (
int, необязательный, по умолчанию 4) — Количество блоков кодировщика. - drop_path_rate (
Union[float, int], необязательный, по умолчанию0.0) — Коэффициент drop path для слияния патчей. - hidden_act (
str, необязательный, по умолчаниюgelu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - use_layer_scale (
bool, необязательный, по умолчаниюTrue) — Использовать ли layer scale. - layer_scale_init_value (
float, необязательный, по умолчанию1e-05) — Масштаб, используемый в слоях само-внимания. 0.1 для базовой модели, 1e-6 для большой. Установите 0, чтобы отключить масштабирование слоя. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов.
Это класс конфигурации для хранения настроек модели PoolFormerModel. Он используется для создания модели Poolformer в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации sail/poolformer_s12
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
класс transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
Параметры
- do_convert_rgb (
bool, kwargs, optional, по умолчаниюNone) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'shortest_edge' -- 224}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюFalse) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'height' -- 224, 'width': 224}): Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию3) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.485, 0.456, 0.406]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.229, 0.224, 0.225]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional, по умолчаниюTrue) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - crop_pct (
float, kwargs, optional, по умолчаниюself.crop_pct) — Доля изображения, подлежащая обрезке. Влияет только в том случае, еслиdo_resizeустановлено вTrue.
Создаёт процессор изображений PoolFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - image_like_kwargs (
dict[str, Any], необязательный) — Флаг для разработчиков, позволяющий передать дополнительные входные данные, похожие на изображения, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например,preprocess(images, masks=masks)— предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использоватьpreprocess(images, image_like_inputs={"masks": masks}). - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
PoolFormerImageProcessorPil
класс transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
Параметры
- do_convert_rgb (
bool, kwargs, optional, по умолчаниюNone) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'shortest_edge' -- 224}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюFalse) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'height' -- 224, 'width': 224}): Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию3) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.485, 0.456, 0.406]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.229, 0.224, 0.225]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional, по умолчаниюTrue) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - crop_pct (
float, kwargs, optional, по умолчаниюself.crop_pct) — Доля изображения, подлежащая обрезке. Влияет только в том случае, еслиdo_resizeустановлено вTrue.
Создаёт процессор изображений PoolFormerImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - image_like_kwargs (
dict[str, Any], необязательный) — Флаг для разработчиков, позволяющий передать дополнительные входные данные, похожие на изображения, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например,preprocess(images, masks=masks)— предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использоватьpreprocess(images, image_like_inputs={"masks": masks}). - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
PoolFormerModel
класс transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
Параметры
- config (PoolFormerConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель Poolformer без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.Tensor)
Параметры
- pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью PoolFormerImageProcessor. Подробности см. в PoolFormerImageProcessor.call() (processor_classиспользует PoolFormerImageProcessor для обработки изображений). - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа.
Возвращает
BaseModelOutputWithNoAttention или tuple(torch.Tensor)
BaseModelOutputWithNoAttention или кортеж
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (PoolFormerConfig) и входных данных.
Метод forward модели PoolFormerModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.Tensorформы(batch_size, num_channels, height, width)) — Последовательность скрытых состояний на выходе последнего слоя модели.hidden_states (
tuple(torch.Tensor), необязательный, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — Кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, num_channels, height, width).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
PoolFormerForImageClassification
класс transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
Параметры
- config (PoolFormerConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель PoolFormer — трансформер с головкой для классификации изображений
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
Параметры
- pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью PoolFormerImageProcessor. Подробности см. в PoolFormerImageProcessor.call() (processor_classиспользует PoolFormerImageProcessor для обработки изображений). - labels (
torch.LongTensorформы(batch_size,), необязательный) — Метки для вычисления функции потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне[0, ..., config.num_labels - 1]. Еслиconfig.num_labels == 1, вычисляется функция потерь регрессии (среднеквадратичная ошибка), еслиconfig.num_labels > 1— функция потерь классификации (кросс-энтропия). - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа.
Возвращает
ImageClassifierOutputWithNoAttention или tuple(torch.Tensor)
Объект ImageClassifierOutputWithNoAttention или кортеж
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (PoolFormerConfig) и входных данных.
Метод forward класса PoolFormerForImageClassification переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
- loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потери классификации (или регрессии, если config.num_labels==1). - logits (
torch.Tensorформы(batch_size, config.num_labels)) — Оценки для классификации (или регрессии, если config.num_labels==1) до применения SoftMax. - hidden_states (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_hidden_states=Trueили приconfig.output_hidden_states=True) — Кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого этапа) формы(batch_size, num_channels, height, width). Скрытые состояния (также называемые картами признаков) модели на выходе каждого этапа.
Пример:
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...